批处理的领域语言
对于任何有经验的批处理架构师来说,Spring Batch 中使用的批处理整体概念应该是熟悉且易于理解的。它包括“作业”和“步骤”,以及由开发人员提供的处理单元,称为 ItemReader 和 ItemWriter。然而,由于 Spring 的模式、操作、模板、回调和惯用法,以下方面存在优化空间:
-
显著提升了关注点分离的清晰度。
-
明确界定了架构层次,并以接口形式提供服务。
-
提供简单且默认的实现,支持开箱即用的快速采用和易用性。
-
显著增强了可扩展性。
下图是一个简化的批处理参考架构版本,该架构已沿用数十年。它概述了构成批处理领域语言的各个组件。这一架构框架是一个蓝图,已在过去几代平台(大型机上的COBOL、Unix上的C语言,以及如今随处可用的Java)上经过数十年的实践验证。JCL和COBOL开发者对这些概念的熟悉程度,很可能与C、C#和Java开发者相当。Spring Batch为健壮、可维护的系统中常见的层次、组件及技术服务提供了物理实现,这些系统用于创建从简单到复杂的批处理应用程序,其基础设施和扩展能力足以应对极其复杂的处理需求。
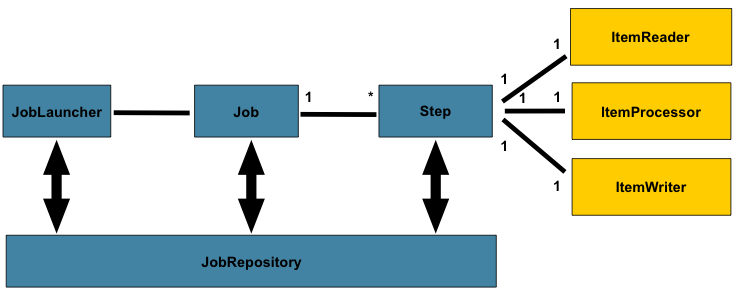
图 1. 批处理模式
前面的图表展示了构成Spring Batch领域语言的关键概念。一个Job包含一个或多个步骤,每个步骤恰好包含一个ItemReader、一个可选的ItemProcessor以及一个ItemWriter。作业通过JobOperator进行操作(启动、停止等),而当前运行进程的元数据则在JobRepository中进行存储和恢复。
任务
本节描述了与批处理作业概念相关的刻板印象。一个 Job 是一个封装了整个批处理流程的实体。与其他 Spring 项目一样,Job 通常通过 XML 配置文件或基于 Java 的配置进行装配。这种配置可以被称为“作业配置”。然而,Job 只是整个层次结构的顶层,如下图所示:
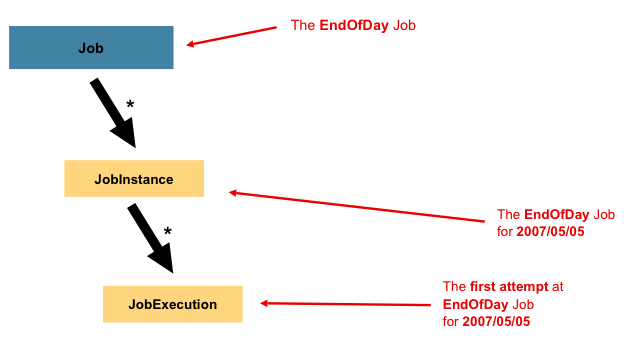
图 2. 作业层级结构
在Spring Batch中,Job 本质上是一个用于承载 Step 实例的容器。它将逻辑上属于同一流程的多个步骤组合在一起,并允许配置对所有步骤都有效的全局属性,例如可重启性。作业配置包含以下内容:
-
作业的名称。
-
Step实例的定义与顺序。 -
作业是否可重启。
- Java
- XML
对于使用 Java 配置的用户,Spring Batch 以 SimpleJob 类的形式提供了 Job 接口的默认实现,它在 Job 的基础上创建了一些标准功能。在使用基于 Java 的配置时,可以使用一组构建器来实例化 Job,如下例所示:
@Bean
public Job footballJob(JobRepository jobRepository) {
    return new JobBuilder("footballJob", jobRepository)
                     .start(playerLoad())
                     .next(gameLoad())
                     .next(playerSummarization())
                     .build();
}
对于使用 XML 配置的用户,Spring Batch 以 SimpleJob 类的形式提供了 Job 接口的默认实现,它在 Job 的基础上创建了一些标准功能。然而,批处理命名空间抽象了直接实例化它的需求。相反,您可以使用 <job> 元素,如下例所示:
<job id="footballJob">
    <step id="playerload" next="gameLoad"/>
    <step id="gameLoad" next="playerSummarization"/>
    <step id="playerSummarization"/>
</job>
JobInstance
JobInstance 指的是逻辑作业运行的概念。考虑一个每天结束时应运行一次的批处理作业,例如前面图表中的 EndOfDay Job。虽然只有一个 EndOfDay 作业,但该 Job 的每次独立运行都必须单独跟踪。对于这个作业,每天对应一个逻辑 JobInstance。例如,有 1 月 1 日的运行、1 月 2 日的运行,依此类推。如果 1 月 1 日的运行第一次失败并在第二天再次运行,它仍然是 1 月 1 日的运行。(通常,这也与其处理的数据相对应,意味着 1 月 1 日的运行处理的是 1 月 1 日的数据)。因此,每个 JobInstance 可以有多次执行(JobExecution 将在本章后面详细讨论),并且在给定时间只能运行一个 JobInstance(对应特定的 Job 和标识性的 JobParameters)。
JobInstance 的定义对要加载的数据完全没有影响。数据如何加载完全由 ItemReader 实现来决定。例如,在 EndOfDay 场景中,数据上可能有一个列指示数据所属的 有效日期 或 计划日期。因此,1 月 1 日的运行将只加载 1 日的数据,而 1 月 2 日的运行将只使用 2 日的数据。由于这种决定很可能是一项业务决策,因此由 ItemReader 来决定。然而,使用相同的 JobInstance 决定了是否使用先前执行的“状态”(即 ExecutionContext,本章稍后将讨论)。使用新的 JobInstance 意味着“从头开始”,而使用现有实例通常意味着“从上次停止的地方继续”。
JobParameters
在讨论了 JobInstance 及其与 Job 的区别之后,很自然会问:“如何区分不同的 JobInstance?”答案是:通过 JobParameters。JobParameters 对象包含一组用于启动批处理作业的参数。这些参数可用于标识作业实例,甚至在运行期间作为参考数据,如下图所示:
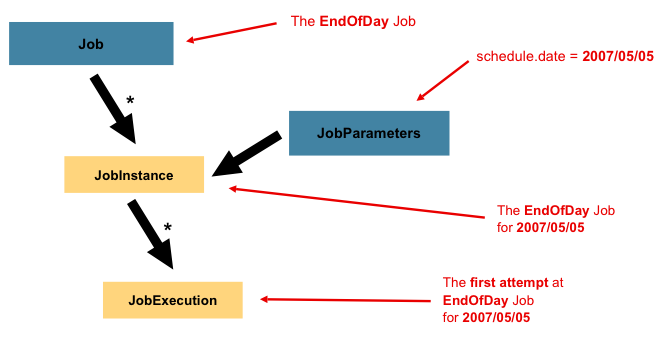
图 3. 作业参数
在作业实例部分的示例中,存在两个实例(一个是1月1日的实例,另一个是1月2日的实例),实际上只有一个 Job,但它拥有两个 JobParameter 对象:一个以作业参数 01-01-2017 启动,另一个以参数 01-02-2017 启动。因此,可以将契约定义为:JobInstance = Job + 标识性的 JobParameters。这使得开发者能够有效控制 JobInstance 的定义方式,因为他们可以控制传入的参数。
并非所有作业参数都需要用于标识 JobInstance。默认情况下,它们确实如此。然而,框架也允许提交带有不参与 JobInstance 标识的参数的 Job。
JobExecution
JobExecution(作业执行)指的是运行作业的一次技术性尝试。执行可能以失败或成功结束,但除非执行成功完成,否则与给定执行对应的 JobInstance(作业实例)不被视为完成。以前面描述的 EndOfDay(日终)Job(作业)为例,考虑一个 2017 年 1 月 1 日的 JobInstance,它在首次运行时失败。如果使用与第一次运行相同的标识性作业参数(2017 年 1 月 1 日)再次运行它,则会创建一个新的 JobExecution。然而,仍然只有一个 JobInstance。
Job 定义了作业的内容及其执行方式,而 JobInstance 是一个纯粹的组织对象,用于将多次执行分组在一起,主要是为了实现正确的重启语义。然而,JobExecution 是记录运行期间实际发生情况的主要存储机制,它包含更多必须控制和持久化的属性,如下表所示:
表 1. JobExecution 属性
| 属性 | 定义 |
|---|---|
Status | 表示执行状态的 BatchStatus 对象。运行时为 BatchStatus#STARTED,失败时为 BatchStatus#FAILED,成功完成时为 BatchStatus#COMPLETED。 |
startTime | 表示执行启动时当前系统时间的 java.time.LocalDateTime。如果作业尚未启动,则此字段为空。 |
endTime | 表示执行完成时当前系统时间的 java.time.LocalDateTime,无论成功与否。如果作业尚未完成,则此字段为空。 |
exitStatus | 表示运行结果的 ExitStatus。它最为重要,因为它包含返回给调用者的退出码。更多详情请参见第 5 章。如果作业尚未完成,则此字段为空。 |
createTime | 表示 JobExecution 首次持久化时当前系统时间的 java.time.LocalDateTime。作业可能尚未启动(因此没有开始时间),但它始终有一个 createTime,这是框架管理作业级 ExecutionContexts 所必需的。 |
lastUpdated | 表示 JobExecution 最后一次持久化时间的 java.time.LocalDateTime。如果作业尚未启动,则此字段为空。 |
executionContext | 包含需要在多次执行之间持久化的任何用户数据的“属性包”。 |
failureExceptions | 在 Job 执行期间遇到的异常列表。如果在 Job 失败期间遇到多个异常,这些信息会很有用。 |
这些属性至关重要,因为它们会被持久化存储,并可用于完整确定执行状态。例如,若 EndOfDay 任务在 1 月 1 日晚上 9:00 开始执行,并于 9:30 失败,批处理元数据表中将记录以下条目:
表 2. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
表 3. BATCH_JOB_EXECUTION_PARAMS
| JOB_EXECUTION_ID | TYPE_CD | KEY_NAME | DATE_VAL | IDENTIFYING |
|---|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 | TRUE |
表 4. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
为了清晰和格式化的需要,列名可能已被缩写或移除。
现在任务已经失败,假设整个晚上都在确定问题,因此"批处理窗口"现已关闭。进一步假设窗口从晚上9:00开始,01-01任务会从上次中断处重新启动,并在9:30成功完成。由于现在已是第二天,01-02任务也必须运行,它紧接着在9:31启动,并在一小时内正常完成于10:30。除非两个任务可能尝试访问相同数据(导致数据库级别的锁定问题),否则并不要求一个JobInstance必须在另一个之后启动。调度器完全有权决定何时运行Job。由于它们是独立的JobInstance,Spring Batch不会阻止它们并发运行(若尝试在另一个任务正在运行时运行相同的JobInstance,则会抛出JobExecutionAlreadyRunningException)。现在JobInstance表和JobParameters表中应各多出一条记录,JobExecution表中会多出两条记录,如下表所示:
表 5. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
| 2 | EndOfDayJob |
表 6. BATCH_JOB_EXECUTION_PARAMS
| JOB_EXECUTION_ID | TYPE_CD | KEY_NAME | DATE_VAL | IDENTIFYING |
|---|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 00:00:00 | TRUE |
| 2 | DATE | schedule.Date | 2017-01-01 00:00:00 | TRUE |
| 3 | DATE | schedule.Date | 2017-01-02 00:00:00 | TRUE |
表 7. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
| 2 | 1 | 2017-01-02 21:00 | 2017-01-02 21:30 | COMPLETED |
| 3 | 2 | 2017-01-02 21:31 | 2017-01-02 22:29 | COMPLETED |
为了清晰和格式化的需要,列名可能已被缩写或移除。
步骤
Step(步骤)是一个领域对象,它封装了批处理作业中一个独立且顺序执行的阶段。因此,每个Job(作业)完全由一个或多个步骤组成。Step包含了定义和控制实际批处理所需的所有信息。这必然是一个模糊的描述,因为任何给定Step的内容完全由编写Job的开发人员自行决定。Step可以像开发人员期望的那样简单或复杂。一个简单的Step可能只需要将数据从文件加载到数据库中,几乎不需要或完全不需要编写代码(取决于所使用的实现)。而一个更复杂的Step可能包含作为处理一部分应用的复杂业务规则。与Job类似,Step也有一个单独的StepExecution(步骤执行),它与一个唯一的JobExecution(作业执行)相关联,如下图所示:
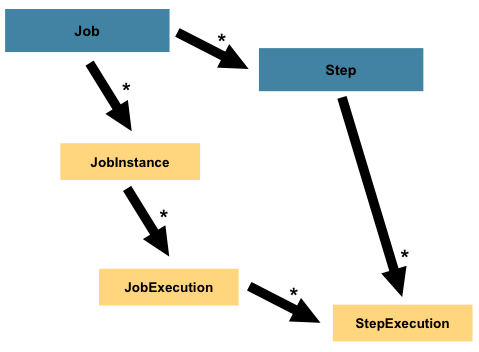
图 4. 带步骤的作业层次结构
StepExecution
StepExecution 表示执行 Step 的单个尝试。每次运行 Step 时都会创建一个新的 StepExecution,类似于 JobExecution。然而,如果一个步骤由于前一个步骤失败而未能执行,则不会为其保留执行记录。只有当 Step 实际启动时,才会创建 StepExecution。
Step(步骤)的执行由 StepExecution 类的对象表示。每次执行都包含对其对应步骤和 JobExecution 的引用,以及与事务相关的数据,例如提交和回滚计数以及开始和结束时间。此外,每个步骤执行都包含一个 ExecutionContext(执行上下文),其中包含开发者需要在批处理运行之间持久保存的任何数据,例如重启所需的统计信息或状态信息。下表列出了 StepExecution 的属性:
表 8. StepExecution 属性
| 属性 | 定义 |
|---|---|
Status | 一个 BatchStatus 对象,表示执行的状态。运行时,状态为 BatchStatus.STARTED。如果失败,状态为 BatchStatus.FAILED。如果成功完成,状态为 BatchStatus.COMPLETED。 |
startTime | 一个 java.time.LocalDateTime,表示执行开始时的当前系统时间。如果步骤尚未开始,此字段为空。 |
endTime | 一个 java.time.LocalDateTime,表示执行完成时的当前系统时间,无论成功与否。如果步骤尚未退出,此字段为空。 |
exitStatus | 表示执行结果的 ExitStatus。它是最重要的,因为它包含返回给调用者的退出码。更多详情请参见第 5 章。如果作业尚未退出,此字段为空。 |
executionContext | 包含需要在多次执行之间持久化的任何用户数据的“属性包”。 |
readCount | 已成功读取的项数。 |
writeCount | 已成功写入的项数。 |
commitCount | 为此执行已提交的事务数。 |
rollbackCount | 由 Step 控制的业务事务已回滚的次数。 |
readSkipCount | read 失败的次数,导致项被跳过。 |
processSkipCount | process 失败的次数,导致项被跳过。 |
filterCount | 已被 ItemProcessor “过滤”的项数。 |
writeSkipCount | write 失败的次数,导致项被跳过。 |
ExecutionContext
ExecutionContext 表示由框架持久化和控制的键/值对集合,为开发者提供了一个存储持久化状态的空间,这些状态的作用域限定于 StepExecution 对象或 JobExecution 对象。(对于熟悉 Quartz 的开发者来说,它非常类似于 JobDataMap。)其最佳使用示例是促进重启功能。以平面文件输入为例,在处理单个行时,框架会在提交点定期持久化 ExecutionContext。这样做可以让 ItemReader 存储其状态,以防在运行期间发生致命错误甚至断电。只需将当前已读取的行数放入上下文中,如下例所示,框架便会处理其余工作:
executionContext.putLong(getKey(LINES_READ_COUNT), reader.getPosition());
以 Job 模式中的 EndOfDay 示例为例,假设存在一个步骤 loadData,用于将文件加载到数据库中。在首次运行失败后,元数据表将如下所示:
表 9. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
表 10. BATCH_JOB_EXECUTION_PARAMS
| JOB_INST_ID | TYPE_CD | KEY_NAME | DATE_VAL |
|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 |
表 11. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
表 12. BATCH_STEP_EXECUTION
| STEP_EXEC_ID | JOB_EXEC_ID | STEP_NAME | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|---|
| 1 | 1 | loadData | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
表 13. BATCH_STEP_EXECUTION_CONTEXT
| STEP_EXEC_ID | SHORT_CONTEXT |
|---|---|
| 1 | {piece.count=40321} |
在前述案例中,Step 运行了30分钟,处理了40,321个“片段”,在此场景中这代表文件中的行数。该值由框架在每次提交前更新,并且可以包含多行数据,对应 ExecutionContext 中的条目。若要在提交前接收通知,需要使用多种 StepListener 实现之一(或 ItemStream),本指南后续章节将对此进行详细讨论。与之前的示例类似,假设 Job 在第二天重启。重启时,最后一次运行的 ExecutionContext 中的值会从数据库中恢复。当 ItemReader 被打开时,它可以检查上下文中是否存在已存储的状态,并据此进行初始化,如下例所示:
if (executionContext.containsKey(getKey(LINES_READ_COUNT))) {
    log.debug("Initializing for restart. Restart data is: " + executionContext);

    long lineCount = executionContext.getLong(getKey(LINES_READ_COUNT));

    LineReader reader = getReader();

    Object record = "";
    while (reader.getPosition() < lineCount && record != null) {
        record = readLine();
    }
}
在这种情况下,前述代码运行后,当前行号是40,322,让Step从上次中断的地方重新开始。你也可以使用ExecutionContext来存储关于运行本身需要持久化的统计信息。例如,如果一个平面文件包含跨多行的待处理订单,可能需要存储已处理的订单数量(这与读取的行数有很大不同),以便在Step结束时发送一封邮件,正文中包含已处理的订单总数。框架会为开发者处理这些存储工作,确保其与单个JobInstance正确关联。判断是否应该使用现有的ExecutionContext可能非常困难。例如,使用上面提到的EndOfDay示例,当01-01的运行第二次重新开始时,框架会识别出这是同一个JobInstance,并在单个Step的基础上,从数据库中提取ExecutionContext,并将其(作为StepExecution的一部分)传递给Step本身。相反,对于01-02的运行,框架会识别出这是一个不同的实例,因此必须将一个空的上下文传递给Step。框架为开发者做了许多这类判断,以确保在正确的时间将状态传递给他们。同样重要的是要注意,在任何给定时间,每个StepExecution只存在一个ExecutionContext。ExecutionContext的客户端应该小心,因为这创建了一个共享的键空间。因此,在存入值时应注意确保没有数据被覆盖。然而,Step在上下文中绝对不存储任何数据,因此不会对框架产生不利影响。
请注意,每个 JobExecution 至少有一个 ExecutionContext,每个 StepExecution 也至少有一个。例如,考虑以下代码片段:
ExecutionContext ecStep = stepExecution.getExecutionContext();
ExecutionContext ecJob = jobExecution.getExecutionContext();
//ecStep does not equal ecJob
如注释所述,ecStep 不等于 ecJob。它们是两个不同的 ExecutionContext。作用域为 Step 的上下文会在 Step 的每个提交点保存,而作用域为 Job 的上下文则会在每个 Step 执行之间保存。
在 ExecutionContext 中,所有非瞬态条目都必须是 Serializable 的。执行上下文的正确序列化是步骤和作业重启能力的基础。如果你使用了非原生可序列化的键或值,则需要采用定制的序列化方法。未能序列化执行上下文可能会危及状态持久化过程,导致失败的作业无法正确恢复。
JobRepository
JobRepository 是所有前述核心组件的持久化机制。它为 JobLauncher、Job 和 Step 的实现提供 CRUD 操作。当 Job 首次启动时,会从该仓库获取一个 JobExecution。此外,在执行过程中,StepExecution 和 JobExecution 的实现会通过传递给该仓库进行持久化存储。
- Java
- XML
在使用 Java 配置时,@EnableBatchProcessing 注解会将 JobRepository 作为自动配置的组件之一提供。
Spring Batch XML 命名空间通过 <job-repository> 标签提供了配置 JobRepository 实例的支持,如下例所示:
<job-repository id="jobRepository"/>
JobOperator
JobOperator 代表了一个简单的接口,用于执行启动、停止和重启作业等操作,如下例所示:
public interface JobOperator {

    JobExecution start(Job job, JobParameters jobParameters) throws Exception;
    JobExecution startNextInstance(Job job) throws Exception;
    boolean stop(JobExecution jobExecution) throws Exception;
    JobExecution restart(JobExecution jobExecution) throws Exception;
    JobExecution abandon(JobExecution jobExecution) throws Exception;

}
Job 启动时会附带一组给定的 JobParameters。预期实现会从 JobRepository 获取有效的 JobExecution 并执行 Job。
ItemReader
ItemReader 是一个抽象概念,表示按顺序为 Step 检索输入数据,每次一个条目。当 ItemReader 已提供完所有可用的条目时,它会通过返回 null 来指示这一点。你可以在 Readers And Writers 中找到关于 ItemReader 接口及其各种实现的更多详细信息。
ItemWriter
ItemWriter 是一个抽象接口,代表 Step 的输出,每次处理一批或一个数据块。通常,ItemWriter 不知道接下来应该接收什么输入,只知道当前调用中传入的数据项。你可以在 读取器和写入器 中找到关于 ItemWriter 接口及其各种实现的更多详细信息。
ItemProcessor
ItemProcessor 是一个抽象概念,代表对数据项的业务处理。当 ItemReader 读取一个数据项,ItemWriter 写入一个数据项时,ItemProcessor 提供了转换或应用其他业务处理的接入点。如果在处理数据项时,确定该数据项无效,返回 null 表示该数据项不应被写出。你可以在 Readers And Writers 中找到关于 ItemProcessor 接口的更多详细信息。
批处理命名空间
之前列出的许多领域概念都需要在 Spring ApplicationContext 中进行配置。虽然您可以在标准 bean 定义中使用上述接口的实现,但为了简化配置,我们提供了一个命名空间,如下例所示:
<beans:beans xmlns="http://www.springframework.org/schema/batch"
xmlns:beans="http://www.springframework.org/schema/beans"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="
   http://www.springframework.org/schema/beans
   https://www.springframework.org/schema/beans/spring-beans.xsd
   http://www.springframework.org/schema/batch
   https://www.springframework.org/schema/batch/spring-batch.xsd">

<job id="ioSampleJob">
    <step id="step1">
        <tasklet>
            <chunk reader="itemReader" writer="itemWriter" commit-interval="2"/>
        </tasklet>
    </step>
</job>

</beans:beans>
自 Spring Batch 6.0 起,批处理 XML 命名空间已被弃用,并将在版本 7.0 中移除。