批处理的领域语言
对于任何有经验的批处理架构师来说,Spring Batch 中使用的批处理总体概念应该是熟悉且舒适的。这里有“作业 (Jobs)”和“步骤 (Steps)”,以及由开发人员提供的处理单元,称为 ItemReader 和 ItemWriter。然而,由于 Spring 的模式、操作、模板、回调和惯用法,以下机会得以出现:
-
显著提高了对清晰关注点分离的遵守。
-
清晰划分的架构层和服务,以接口形式提供。
-
简单且默认的实现,允许快速采用和开箱即用的易用性。
-
极大增强了可扩展性。
下图是几十年来使用的批量参考架构的简化版本。它提供了对构成批量处理领域语言的组件的概述。该架构框架是一个蓝图,通过过去几代平台(大型机上的COBOL、Unix上的C,以及现在随处可用的Java)的数十年实现得到了验证。JCL 和 COBOL 开发人员很可能与 C、C# 和 Java 开发人员一样熟悉这些概念。Spring Batch 提供了 robust 且可维护系统中常见的各层、组件和技术服务的物理实现,这些系统用于解决从简单到复杂的批量应用程序的创建,并且具有应对非常复杂处理需求的基础设施和扩展功能。
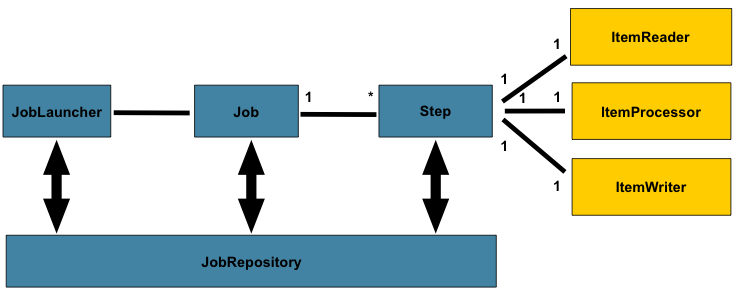
图1. 批处理刻板印象
前面的图表突出了构成 Spring Batch 领域语言的关键概念。一个 Job 包含一个或多个步骤,每个步骤恰好有一个 ItemReader、一个 ItemProcessor 和一个 ItemWriter。作业需要通过 JobLauncher 启动,并且需要在 JobRepository 中存储有关当前运行进程的元数据。
任务
本节描述了与批处理作业概念相关的刻板印象。Job 是一个封装整个批处理过程的实体。与其他 Spring 项目常见的情况一样,Job 可以通过 XML 配置文件或基于 Java 的配置进行组装。这种配置可以被称为“作业配置”。然而,Job 仅仅是整体层次结构的顶层,如下图所示:
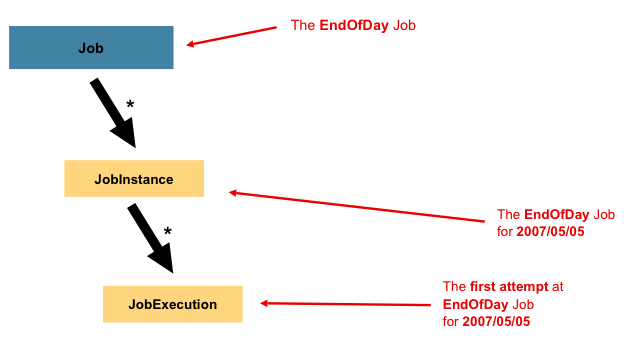
图 2. 作业层次结构
在 Spring Batch 中,Job 仅仅是 Step 实例的容器。它将多个在流程中逻辑上属于一起的步骤组合在一起,并允许对所有步骤全局适用的属性进行配置,例如可重启性。作业配置包含:
-
作业的名称。
-
Step实例的定义和排序。 -
作业是否可重启。
- Java
- XML
对于使用 Java 配置的用户,Spring Batch 提供了 Job 接口的默认实现,即 SimpleJob 类,它在 Job 的基础上创建了一些标准功能。在使用基于 Java 的配置时,提供了一组构建器用于实例化 Job,如下例所示:
@Bean
public Job footballJob(JobRepository jobRepository) {
    return new JobBuilder("footballJob", jobRepository)
                     .start(playerLoad())
                     .next(gameLoad())
                     .next(playerSummarization())
                     .build();
}
对于使用 XML 配置的用户,Spring Batch 提供了 Job 接口的默认实现,即 SimpleJob 类,它在 Job 的基础上创建了一些标准功能。然而,批处理命名空间抽象掉了直接实例化它的需求。相反,您可以使用 <job> 元素,如下例所示:
<job id="footballJob">
    <step id="playerload" next="gameLoad"/>
    <step id="gameLoad" next="playerSummarization"/>
    <step id="playerSummarization"/>
</job>
JobInstance
JobInstance 指的是逻辑上的一次作业运行的概念。考虑一个应该在一天结束时运行一次的批处理作业,例如前面图表中的 EndOfDay Job。虽然只有一个 EndOfDay 作业,但每次单独运行该作业都需要分别跟踪。在这种情况下,每天有一个逻辑上的 JobInstance。例如,有1月1日的运行、1月2日的运行,等等。如果1月1日的运行第一次失败了,并且在第二天重新运行,它仍然属于1月1日的运行。(通常,这也与它正在处理的数据相对应,也就是说,1月1日的运行处理的是1月1日的数据)。因此,每个 JobInstance 可以有多个执行(JobExecution 在本章后面会有更详细的讨论),并且在任何给定时间,只能运行一个 JobInstance(它对应于特定的 Job 和标识性的 JobParameters)。
JobInstance 的定义与要加载的数据完全没有关系。数据如何加载完全由 ItemReader 的实现来决定。例如,在 EndOfDay 场景中,数据可能包含一个表示 生效日期 或 计划日期 的列,该列指定了数据所属的日期。因此,1月1日的运行只会加载1日的数据,而1月2日的运行只会使用2日的数据。由于这种判断很可能是业务决策的一部分,因此它被留给 ItemReader 来决定。然而,使用相同的 JobInstance 决定了是否使用之前执行的“状态”(即本章稍后讨论的 ExecutionContext)。使用一个新的 JobInstance 意味着“从头开始”,而使用现有的实例通常意味着“从上次中断的地方继续”。
JobParameters
在讨论了 JobInstance 以及它与 Job 的区别之后,自然而然会提出一个问题:“如何区分一个 JobInstance 和另一个?” 答案是:JobParameters。JobParameters 对象持有一组用于启动批处理作业的参数。这些参数可以用于标识,甚至在运行期间作为参考数据使用,如下图所示:
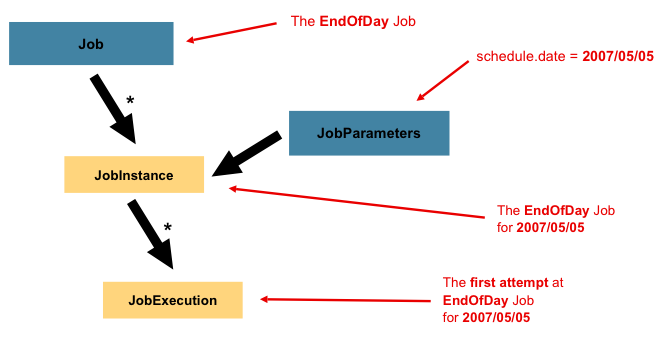
图 3. 作业参数
在前面的例子中,存在两个实例,一个是在1月1日,另一个是在1月2日。实际上只有一个 Job,但它有两个 JobParameter 对象:一个是使用参数 01-01-2017 启动的,另一个是使用参数 01-02-2017 启动的。因此,可以将契约定义为:JobInstance = Job + 可标识的 JobParameters。这使得开发人员能够有效地控制 JobInstance 的定义方式,因为他们掌控着传递哪些参数。
并非所有作业参数都必须参与 JobInstance 的标识。默认情况下,它们确实如此。但是,框架还允许提交带有不参与 JobInstance 标识的参数的 Job。
作业执行
JobExecution 指的是运行一个 Job 的单次尝试所涉及的技术概念。一次执行可能会以失败或成功结束,但只有当执行成功完成时,与给定执行对应的 JobInstance 才会被认为是已完成的。以之前描述的 EndOfDay Job 为例,假设 2017 年 1 月 1 日 的 JobInstance 第一次运行时失败了。如果使用与第一次运行相同的标识性 Job 参数(即 2017 年 1 月 1 日)再次运行该任务,则会创建一个新的 JobExecution。然而,仍然只有一个 JobInstance。
一个 Job 定义了作业是什么以及它如何被执行,而 JobInstance 是一个纯粹的组织对象,用于将执行分组在一起,主要是为了启用正确的重启语义。然而,JobExecution 是实际运行过程中发生情况的主要存储机制,并且包含许多必须被控制和持久化的属性,如下表所示:
表 1. JobExecution 属性
| 属性 | 定义 |
|---|---|
Status | 一个 BatchStatus 对象,用于指示执行的状态。在运行时,它是 BatchStatus#STARTED。如果失败,则为 BatchStatus#FAILED。如果成功完成,则为 BatchStatus#COMPLETED |
startTime | 一个 java.time.LocalDateTime,表示执行开始时的当前系统时间。如果作业尚未开始,此字段为空。 |
endTime | 一个 java.time.LocalDateTime,表示执行结束时的当前系统时间,无论是否成功。如果作业尚未完成,此字段为空。 |
exitStatus | ExitStatus,指示运行的结果。它非常重要,因为它包含返回给调用者的退出代码。有关更多详细信息,请参阅第 5 章。如果作业尚未完成,此字段为空。 |
createTime | 一个 java.time.LocalDateTime,表示 JobExecution 首次被持久化时的当前系统时间。作业可能尚未开始(因此没有开始时间),但它始终具有 createTime,这是框架管理作业级别 ExecutionContexts 所必需的。 |
lastUpdated | 一个 java.time.LocalDateTime,表示 JobExecution 最后一次被持久化的时间。如果作业尚未开始,此字段为空。 |
executionContext | 包含任何需要在执行之间持久化的用户数据的“属性包”。 |
failureExceptions | 在执行 Job 过程中遇到的异常列表。如果在作业失败期间遇到多个异常,这些可能会很有用。 |
这些属性很重要,因为它们会被持久化,并且可以用于完全确定一个执行的状态。例如,如果 01-01 的 EndOfDay 作业在晚上 9:00 执行,并在 9:30 失败,则会在批处理元数据表中记录以下条目:
表 2. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
表 3. BATCH_JOB_EXECUTION_PARAMS
| JOB_EXECUTION_ID | TYPE_CD | KEY_NAME | DATE_VAL | IDENTIFYING |
|---|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 | TRUE |
表 4. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
为了清晰和格式化的需要,列名可能已被缩写或删除。
既然作业已经失败,假设花了整个晚上才确定问题所在,因此“批处理窗口”现在已经关闭。进一步假设窗口从晚上9:00开始,作业再次为 01-01 启动,从上次中断的地方继续,并于 9:30 成功完成。由于现在已经是第二天,因此还需要运行 01-02 的作业,它在 9:31 立即启动,并在其正常的1小时运行时间内于 10:30 完成。除非存在两个作业可能尝试访问相同数据的风险(这会在数据库级别引发锁定问题),否则一个 JobInstance 并不要求必须在另一个之后启动。完全由调度器决定何时运行某个 Job。由于它们是独立的 JobInstances,Spring Batch 不会尝试阻止它们并发运行。(尝试在另一个实例已经在运行时启动相同的 JobInstance 将导致抛出 JobExecutionAlreadyRunningException)。此时,在 JobInstance 和 JobParameters 表中应各有额外的一条记录,在 JobExecution 表中则应有两条额外的记录,如下表所示:
表 5. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
| 2 | EndOfDayJob |
表 6. BATCH_JOB_EXECUTION_PARAMS
| JOB_EXECUTION_ID | TYPE_CD | KEY_NAME | DATE_VAL | IDENTIFYING |
|---|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 00:00:00 | TRUE |
| 2 | DATE | schedule.Date | 2017-01-01 00:00:00 | TRUE |
| 3 | DATE | schedule.Date | 2017-01-02 00:00:00 | TRUE |
表 7. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
| 2 | 1 | 2017-01-02 21:00 | 2017-01-02 21:30 | COMPLETED |
| 3 | 2 | 2017-01-02 21:31 | 2017-01-02 22:29 | COMPLETED |
为了清晰和格式化的需要,列名可能已被缩写或删除。
步骤
一个 Step 是一个域对象,它封装了批处理作业中独立且顺序的阶段。因此,每个 Job 完全由一个或多个步骤组成。Step 包含定义和控制实际批处理过程所需的所有信息。这是一个必然模糊的描述,因为任何给定 Step 的内容由编写 Job 的开发人员自行决定。Step 可以根据开发人员的需求变得简单或复杂。一个简单的 Step 可能会从文件中加载数据到数据库中,这可能需要很少或不需要代码(具体取决于所使用的实现)。更复杂的 Step 可能在处理过程中应用复杂的业务规则。与 Job 类似,Step 有一个单独的 StepExecution,它与唯一的 JobExecution 相关联,如下图所示:
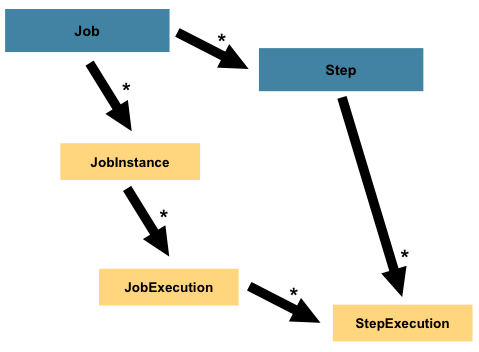
图 4. 带有步骤的作业层次结构
StepExecution
StepExecution 表示对 Step 的一次执行尝试。每次运行一个 Step 时,都会创建一个新的 StepExecution,这与 JobExecution 类似。但是,如果一个步骤由于其前一个步骤失败而未能执行,则不会为其持久化任何执行记录。只有当 Step 实际启动时,才会创建 StepExecution。
Step 执行由 StepExecution 类的对象表示。每次执行都包含对其对应步骤和 JobExecution 的引用,以及与事务相关的数据,例如提交和回滚次数以及开始和结束时间。此外,每个步骤执行包含一个 ExecutionContext,其中包含开发人员需要在批处理运行之间持久化的任何数据,例如用于重启所需的统计信息或状态信息。下表列出了 StepExecution 的属性:
表 8. StepExecution 属性
| 属性 | 定义 |
|---|---|
Status | 一个 BatchStatus 对象,表示执行的状态。在运行期间,状态为 BatchStatus.STARTED。如果失败,状态为 BatchStatus.FAILED。如果成功完成,状态为 BatchStatus.COMPLETED。 |
startTime | 一个 java.time.LocalDateTime,表示执行开始时的当前系统时间。如果步骤尚未开始,此字段为空。 |
endTime | 一个 java.time.LocalDateTime,表示执行结束时的当前系统时间,无论是否成功。如果步骤尚未退出,此字段为空。 |
exitStatus | 表示执行结果的 ExitStatus。它非常重要,因为它包含返回给调用者的退出代码。更多详细信息请参阅第 5 章。如果作业尚未退出,此字段为空。 |
executionContext | 包含任何需要在执行之间持久化的用户数据的“属性包”。 |
readCount | 成功读取的项目数量。 |
writeCount | 成功写入的项目数量。 |
commitCount | 为此执行提交的事务数量。 |
rollbackCount | 由 Step 控制的业务事务回滚的次数。 |
readSkipCount | read 失败导致跳过项目的次数。 |
processSkipCount | process 失败导致跳过项目的次数。 |
filterCount | 被 ItemProcessor “过滤”掉的项目数量。 |
writeSkipCount | write 失败导致跳过项目的次数。 |
ExecutionContext
ExecutionContext 表示由框架持久化和控制的一组键值对,它为开发人员提供了一个存储空间,用于保存与 StepExecution 对象或 JobExecution 对象作用域相关的持久状态。 (对于熟悉 Quartz 的用户来说,它与 JobDataMap 非常相似。)最佳使用案例是支持重启功能。以处理平面文件输入为例,在处理每一行时,框架会在提交点周期性地持久化 ExecutionContext。这样做可以让 ItemReader 在运行过程中发生致命错误甚至断电的情况下保存其状态。只需要将当前已读取的行数放入上下文中,如下例所示,框架会完成其余的工作:
executionContext.putLong(getKey(LINES_READ_COUNT), reader.getPosition());
使用 Job 类型部分中的 EndOfDay 示例作为示例,假设有一个步骤 loadData,它将文件加载到数据库中。在第一次运行失败后,元数据表将如下例所示:
表 9. BATCH_JOB_INSTANCE
| JOB_INST_ID | JOB_NAME |
|---|---|
| 1 | EndOfDayJob |
表 10. BATCH_JOB_EXECUTION_PARAMS
| JOB_INST_ID | TYPE_CD | KEY_NAME | DATE_VAL |
|---|---|---|---|
| 1 | DATE | schedule.Date | 2017-01-01 |
表 11. BATCH_JOB_EXECUTION
| JOB_EXEC_ID | JOB_INST_ID | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|
| 1 | 1 | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
表 12. BATCH_STEP_EXECUTION
| STEP_EXEC_ID | JOB_EXEC_ID | STEP_NAME | START_TIME | END_TIME | STATUS |
|---|---|---|---|---|---|
| 1 | 1 | loadData | 2017-01-01 21:00 | 2017-01-01 21:30 | FAILED |
表 13. BATCH_STEP_EXECUTION_CONTEXT
| STEP_EXEC_ID | SHORT_CONTEXT |
|---|---|
| 1 | {piece.count=40321} |
在前面的情况下,Step 运行了 30 分钟并处理了 40,321 个“片段”,在这个场景中,这些片段代表文件中的行。此值会在每次提交之前由框架更新,并且可能包含与 ExecutionContext 中的条目相对应的多行数据。要在提交之前获得通知,需要使用多种 StepListener 实现之一(或 ItemStream),这些内容将在本指南的后续部分详细讨论。与前面的例子一样,假设该 Job 在第二天重启。当它重启时,上次运行的 ExecutionContext 中的值将从数据库中重新构建。当 ItemReader 打开时,它可以检查上下文中是否有任何存储的状态,并从中初始化自身,如下例所示:
if (executionContext.containsKey(getKey(LINES_READ_COUNT))) {
    log.debug("Initializing for restart. Restart data is: " + executionContext);

    long lineCount = executionContext.getLong(getKey(LINES_READ_COUNT));

    LineReader reader = getReader();

    Object record = "";
    while (reader.getPosition() < lineCount && record != null) {
        record = readLine();
    }
}
在这种情况下,前面的代码运行后,当前行是 40,322,这使得 Step 可以从上次中断的地方重新开始。你还可以使用 ExecutionContext 来保存关于运行本身需要持久化的统计信息。例如,如果一个平面文件包含分布在多行上的订单用于处理,可能有必要存储已处理的订单数量(这与读取的行数有很大不同),以便在 Step 结束时发送一封包含处理订单总数的电子邮件。框架会为开发人员处理这些存储问题,并正确地将其限定在一个单独的 JobInstance 范围内。判断是否应该使用现有的 ExecutionContext 可能非常困难。例如,使用上面提到的 EndOfDay 示例,当 01-01 运行第二次开始时,框架识别到这是相同的 JobInstance,并且在每个 Step 的基础上,从数据库中提取 ExecutionContext 并通过 StepExecution 将其传递给 Step 本身。相反,对于 01-02 运行,框架识别到这是一个不同的实例,因此必须向 Step 提供一个空的上下文。框架为开发人员做出了许多类似的判断,以确保状态在正确的时间提供给他们。还需要注意的是,在任何给定时间,每个 StepExecution 都恰好存在一个 ExecutionContext。ExecutionContext 的使用者应小心谨慎,因为这会创建一个共享的键空间。因此,在放置值时应小心,以确保不会覆盖数据。然而,Step 在上下文中绝对不存储任何数据,因此不可能对框架产生不利影响。
请注意,每个 JobExecution 至少有一个 ExecutionContext,每个 StepExecution 也有一个。例如,考虑以下代码片段:
ExecutionContext ecStep = stepExecution.getExecutionContext();
ExecutionContext ecJob = jobExecution.getExecutionContext();
//ecStep does not equal ecJob
正如评论中所述,ecStep 不等于 ecJob。它们是两个不同的 ExecutionContext。作用域为 Step 的那个在 Step 的每个提交点保存,而作用域为 Job 的那个在每次 Step 执行之间保存。
在 ExecutionContext 中,所有非瞬态条目都必须是 Serializable。执行上下文的正确序列化是步骤和作业重启能力的基础。如果你使用了非本地可序列化的键或值,则需要采用定制的序列化方法。未能序列化执行上下文可能会危及状态持久化过程,导致失败的作业无法正确恢复。
JobRepository
JobRepository 是前面提到的所有刻板印象的持久化机制。它为 JobLauncher、Job 和 Step 的实现提供了 CRUD 操作。当一个 Job 首次启动时,从仓库中获取一个 JobExecution。此外,在执行过程中,通过将 StepExecution 和 JobExecution 的实现传递给仓库来持久化它们。
- Java
- XML
在使用 Java 配置时,@EnableBatchProcessing 注解提供了一个 JobRepository,它是自动配置的组件之一。
Spring Batch XML 命名空间通过 <job-repository> 标签提供了对配置 JobRepository 实例的支持,如下例所示:
<job-repository id="jobRepository"/>
JobLauncher
JobLauncher 表示一个简单的接口,用于通过给定的一组 JobParameters 启动一个 Job,如下例所示:
public interface JobLauncher {

public JobExecution run(Job job, JobParameters jobParameters)
            throws JobExecutionAlreadyRunningException, JobRestartException,
                   JobInstanceAlreadyCompleteException, JobParametersInvalidException;
}
预计实现方案将从 JobRepository 获取有效的 JobExecution 并执行该 Job。
ItemReader
ItemReader 是一种抽象,表示为 Step 检索输入,一次一个项目。当 ItemReader 已经耗尽它可以提供的项目时,它通过返回 null 来指示这一点。您可以在此处找到有关 ItemReader 接口及其各种实现的更多详细信息:Readers And Writers。
ItemWriter
ItemWriter 是一种抽象,表示 Step 的输出,一次写入一批或一块项目。通常,ItemWriter 对其接下来应接收的输入没有任何了解,仅知道在其当前调用中传递的项目。您可以从 Readers And Writers 中找到有关 ItemWriter 接口及其各种实现的更多详细信息。
ItemProcessor
ItemProcessor 是一个表示项业务处理的抽象。虽然 ItemReader 读取一个项,ItemWriter 写入一个项,但 ItemProcessor 提供了一个用于转换或应用其他业务处理的接入点。如果在处理项的过程中发现该项无效,返回 null 表示该项不应被写入。您可以在 Readers And Writers 中找到有关 ItemProcessor 接口的更多详细信息。
批量命名空间
前面列出的许多域概念需要在 Spring ApplicationContext 中进行配置。虽然可以使用上述接口的实现来进行标准的 Bean 定义,但为了简化配置,提供了一个命名空间,如下例所示:
<beans:beans xmlns="http://www.springframework.org/schema/batch"
xmlns:beans="http://www.springframework.org/schema/beans"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="
   http://www.springframework.org/schema/beans
   https://www.springframework.org/schema/beans/spring-beans.xsd
   http://www.springframework.org/schema/batch
   https://www.springframework.org/schema/batch/spring-batch.xsd">

<job id="ioSampleJob">
    <step id="step1">
        <tasklet>
            <chunk reader="itemReader" writer="itemWriter" commit-interval="2"/>
        </tasklet>
    </step>
</job>

</beans:beans>