常见的批处理模式
一些批处理任务可以完全通过 Spring Batch 中的现成组件来组装。例如,ItemReader 和 ItemWriter 的实现可以配置以覆盖广泛的场景。然而,在大多数情况下,必须编写自定义代码。应用开发者的主要 API 入口是 Tasklet、ItemReader、ItemWriter 以及各种监听器接口。大多数简单的批处理任务可以使用 Spring Batch ItemReader 提供的现成输入,但在处理和写入过程中通常存在自定义需求,这需要开发者实现一个 ItemWriter 或 ItemProcessor。
在本章中,我们提供了一些自定义业务逻辑中常见模式的示例。这些示例主要涉及监听器接口。需要注意的是,如果合适,ItemReader 或 ItemWriter 也可以实现监听器接口。
日志记录项处理和失败
一个常见的用例是在步骤中需要对每个项的错误进行特殊处理,例如记录到特殊的通道或向数据库插入一条记录。基于块的 Step(由步骤工厂 Bean 创建)允许用户通过简单的 ItemReadListener 来处理 read 时的错误,以及通过 ItemWriteListener 来处理 write 时的错误。以下代码片段展示了一个记录 read 和 write 失败的监听器:
public class ItemFailureLoggerListener extends ItemListenerSupport {

    private static Log logger = LogFactory.getLog("item.error");

    public void onReadError(Exception ex) {
        logger.error("Encountered error on read", e);
    }

    public void onWriteError(Exception ex, List<? extends Object> items) {
        logger.error("Encountered error on write", ex);
    }
}
实现此监听器后,必须将其注册到一个步骤中。
- Java
- XML
下面的示例展示了如何在 Java 中为一个步骤注册监听器:
@Bean
public Step simpleStep(JobRepository jobRepository) {
	return new StepBuilder("simpleStep", jobRepository)
				...
				.listener(new ItemFailureLoggerListener())
				.build();
}
下面的示例展示了如何在 XML 中为一个步骤注册监听器:
<step id="simpleStep">
...
<listeners>
    <listener>
        <bean class="org.example...ItemFailureLoggerListener"/>
    </listener>
</listeners>
</step>
如果您的监听器在 onError() 方法中执行任何操作,该操作必须位于将要回滚的事务内。如果您需要在 onError() 方法中使用事务性资源(例如数据库),请考虑为此方法添加一个声明式事务(具体细节参见 Spring Core 参考指南),并将其传播属性 propagation 的值设置为 REQUIRES_NEW。
因商业原因手动停止作业
Spring Batch 通过 JobOperator 接口提供了一个 stop() 方法,但这主要是供操作员使用,而不是应用程序开发人员使用。有时,在业务逻辑内部停止作业执行会更加方便或更具意义。
最简单的方法是抛出一个 RuntimeException(既不会被无限重试也不会被跳过的异常)。例如,可以使用自定义异常类型,如下例所示:
public class PoisonPillItemProcessor<T> implements ItemProcessor<T, T> {

    @Override
    public T process(T item) throws Exception {
        if (isPoisonPill(item)) {
            throw new PoisonPillException("Poison pill detected: " + item);
        }
        return item;
    }
}
另一种阻止步骤执行的简单方法是让 ItemReader 返回 null,如下例所示:
public class EarlyCompletionItemReader implements ItemReader<T> {

    private ItemReader<T> delegate;

    public void setDelegate(ItemReader<T> delegate) { ... }

    public T read() throws Exception {
        T item = delegate.read();
        if (isEndItem(item)) {
            return null; // end the step here
        }
        return item;
    }

}
上一个示例实际上依赖于这样一个事实,即存在 CompletionPolicy 策略的默认实现,当要处理的项为 null 时,它会发出一个完整的批处理信号。可以通过 SimpleStepFactoryBean 将更复杂的完成策略实现并注入到 Step 中。
- Java
- XML
下面的示例展示了如何在 Java 中将完成策略注入到步骤中:
@Bean
public Step simpleStep(JobRepository jobRepository, PlatformTransactionManager transactionManager) {
	return new StepBuilder("simpleStep", jobRepository)
				.<String, String>chunk(new SpecialCompletionPolicy(), transactionManager)
				.reader(reader())
				.writer(writer())
				.build();
}
下面的示例展示了如何在 XML 中将完成策略注入到步骤中:
<step id="simpleStep">
    <tasklet>
        <chunk reader="reader" writer="writer" commit-interval="10"
               chunk-completion-policy="completionPolicy"/>
    </tasklet>
</step>

<bean id="completionPolicy" class="org.example...SpecialCompletionPolicy"/>
另一种方法是在 StepExecution 中设置一个标志位,该标志位会在框架中的 Step 实现类在处理项目之间进行检查。为了实现这种替代方案,我们需要访问当前的 StepExecution,这可以通过实现一个 StepListener 并将其注册到 Step 来实现。以下示例展示了一个设置该标志位的监听器:
public class CustomItemWriter extends ItemListenerSupport implements StepListener {

    private StepExecution stepExecution;

    public void beforeStep(StepExecution stepExecution) {
        this.stepExecution = stepExecution;
    }

    public void afterRead(Object item) {
        if (isPoisonPill(item)) {
            stepExecution.setTerminateOnly();
       }
    }

}
当标志被设置时,默认行为是该步骤会抛出一个 JobInterruptedException。此行为可以通过 StepInterruptionPolicy 进行控制。然而,唯一的选择是抛出或不抛出异常,因此这总是会导致作业出现异常终止。
添加页脚记录
通常,在写入平面文件时,需要在文件末尾追加一个“页脚”记录,此操作需在所有处理完成之后进行。这可以通过 Spring Batch 提供的 FlatFileFooterCallback 接口来实现。FlatFileFooterCallback(及其对应的部分 FlatFileHeaderCallback)是 FlatFileItemWriter 的可选属性,可以添加到项写入器中。
- Java
- XML
下面的示例展示了如何在 Java 中使用 FlatFileHeaderCallback 和 FlatFileFooterCallback:
@Bean
public FlatFileItemWriter<String> itemWriter(Resource outputResource) {
	return new FlatFileItemWriterBuilder<String>()
			.name("itemWriter")
			.resource(outputResource)
			.lineAggregator(lineAggregator())
			.headerCallback(headerCallback())
			.footerCallback(footerCallback())
			.build();
}
下面的示例展示了如何在 XML 中使用 FlatFileHeaderCallback 和 FlatFileFooterCallback:
<bean id="itemWriter" class="org.spr...FlatFileItemWriter">
    <property name="resource" ref="outputResource" />
    <property name="lineAggregator" ref="lineAggregator"/>
    <property name="headerCallback" ref="headerCallback" />
    <property name="footerCallback" ref="footerCallback" />
</bean>
页脚回调接口只有一个方法,当需要写入页脚时会被调用,如下所示的接口定义:
public interface FlatFileFooterCallback {

    void writeFooter(Writer writer) throws IOException;

}
编写摘要页脚
一个涉及页脚记录的常见需求是在输出过程中汇总信息,并将这些信息附加到文件的末尾。这个页脚通常作为文件的总结,或者提供一个校验和。
例如,如果批处理作业正在将 Trade 记录写入平面文件,并且有这样一个要求:即将所有 Trades 的总金额放在文件尾部,那么可以使用以下的 ItemWriter 实现:
public class TradeItemWriter implements ItemWriter<Trade>,
                                        FlatFileFooterCallback {

    private ItemWriter<Trade> delegate;

    private BigDecimal totalAmount = BigDecimal.ZERO;

    public void write(Chunk<? extends Trade> items) throws Exception {
        BigDecimal chunkTotal = BigDecimal.ZERO;
        for (Trade trade : items) {
            chunkTotal = chunkTotal.add(trade.getAmount());
        }

        delegate.write(items);

        // After successfully writing all items
        totalAmount = totalAmount.add(chunkTotal);
    }

    public void writeFooter(Writer writer) throws IOException {
        writer.write("Total Amount Processed: " + totalAmount);
    }

    public void setDelegate(ItemWriter delegate) {...}
}
这个 TradeItemWriter 存储了一个 totalAmount 值,该值会随着每个写入的 Trade 项的 amount 而增加。在最后一个 Trade 处理完成后,框架会调用 writeFooter,将 totalAmount 写入文件。需要注意的是,write 方法使用了一个临时变量 chunkTotal,用于存储块中 Trade 金额的总计。这样做是为了确保如果在 write 方法中发生跳过操作,totalAmount 不会被改变。只有在 write 方法的末尾,在确保不会抛出异常的情况下,才会更新 totalAmount。
为了让 writeFooter 方法被调用,必须将实现 FlatFileFooterCallback 的 TradeItemWriter 配置到 FlatFileItemWriter 中作为 footerCallback。
- Java
- XML
下面的示例展示了如何在 Java 中配置 TradeItemWriter:
@Bean
public TradeItemWriter tradeItemWriter() {
	TradeItemWriter itemWriter = new TradeItemWriter();

	itemWriter.setDelegate(flatFileItemWriter(null));

	return itemWriter;
}

@Bean
public FlatFileItemWriter<String> flatFileItemWriter(Resource outputResource) {
	return new FlatFileItemWriterBuilder<String>()
			.name("itemWriter")
			.resource(outputResource)
			.lineAggregator(lineAggregator())
			.footerCallback(tradeItemWriter())
			.build();
}
下面的示例展示了如何在 XML 中配置 TradeItemWriter:
<bean id="tradeItemWriter" class="..TradeItemWriter">
    <property name="delegate" ref="flatFileItemWriter" />
</bean>

<bean id="flatFileItemWriter" class="org.spr...FlatFileItemWriter">
   <property name="resource" ref="outputResource" />
   <property name="lineAggregator" ref="lineAggregator"/>
   <property name="footerCallback" ref="tradeItemWriter" />
</bean>
到目前为止,TradeItemWriter 的实现方式只有在 Step 不可重启的情况下才能正确工作。这是因为该类是有状态的(因为它存储了 totalAmount),但 totalAmount 没有持久化到数据库中。因此,在重启时无法恢复该值。为了使这个类具备重启能力,应该实现 ItemStream 接口及其 open 和 update 方法,如下例所示:
public void open(ExecutionContext executionContext) {
    if (executionContext.containsKey("total.amount") {
        totalAmount = (BigDecimal) executionContext.get("total.amount");
    }
}

public void update(ExecutionContext executionContext) {
    executionContext.put("total.amount", totalAmount);
}
更新方法会在该对象持久化到数据库之前,将 totalAmount 的最新版本存储到 ExecutionContext 中。而 open 方法会从 ExecutionContext 中检索任何已存在的 totalAmount,并将其作为处理的起点,从而使得 TradeItemWriter 在 Step 重新启动时可以从上次停止的地方继续执行。
驱动基于查询的 ItemReaders
在 关于读取器和写入器的章节 中,讨论了使用分页进行数据库输入的内容。许多数据库供应商(例如 DB2)具有极其悲观的锁定策略,如果正在读取的表还需要被在线应用程序的其他部分使用,这可能会导致问题。此外,在某些供应商的数据库上,对极大数据集打开游标也可能引发问题。因此,许多项目更倾向于使用“驱动查询 (Driving Query)”的方式来读取数据。这种方法通过迭代键而不是需要返回的整个对象来工作,如下图所示:
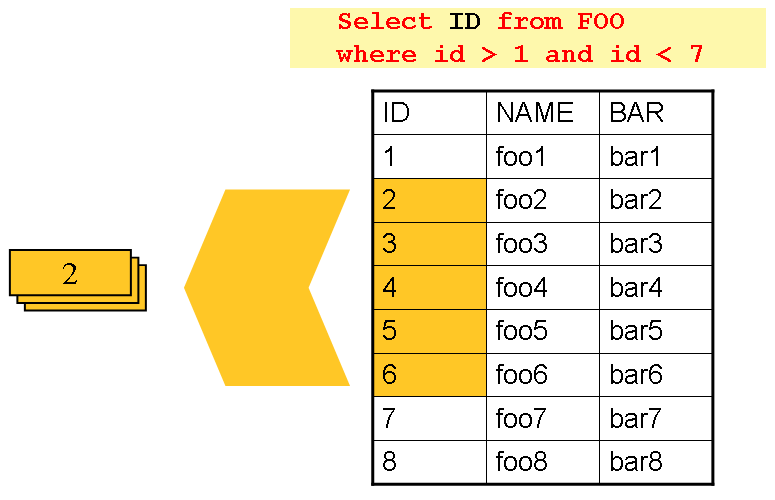
图 1. 驱动查询作业
正如您所见,前面图像中显示的示例使用了与基于游标的示例中相同的 'FOO' 表。然而,与选择整行不同,SQL 语句中仅选择了 ID。因此,从 read 返回的不是一个 FOO 对象,而是一个 Integer。然后可以使用这个数字查询 'details',这是一个完整的 Foo 对象,如下图所示:
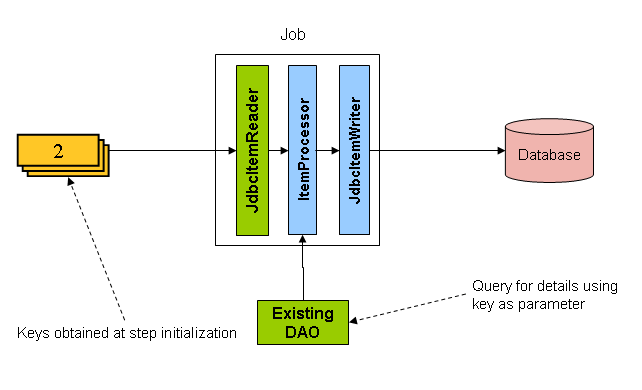
图 2. 驱动查询示例
一个 ItemProcessor 应用于将从驱动查询中获取的键转换为完整的 Foo 对象。可以使用现有的 DAO 根据该键查询完整的对象。
多行记录
虽然在平面文件中通常每条记录都限制在一行内,但常见的情况是,一个文件可能包含跨越多行且具有多种格式的记录。以下文件摘录展示了一种这样的排列示例:
HEA;0013100345;2007-02-15
NCU;Smith;Peter;;T;20014539;F
BAD;;Oak Street 31/A;;Small Town;00235;IL;US
FOT;2;2;267.34
从以“HEA”开头的行到以“FOT”开头的行之间的所有内容被视为一条记录。为了正确处理这种情况,必须考虑以下几点:
-
与其一次读取一条记录,
ItemReader必须将多行记录的每一行作为一组读取,以便能够完整地传递给ItemWriter。 -
每种行类型可能需要以不同的方式分词。
因为单条记录跨越多行,并且我们可能不知道有多少行,所以 ItemReader 必须小心确保始终读取整个记录。为了实现这一点,应实现一个自定义的 ItemReader 作为 FlatFileItemReader 的包装器。
- Java
- XML
下面的示例展示了如何在 Java 中实现自定义的 ItemReader:
@Bean
public MultiLineTradeItemReader itemReader() {
	MultiLineTradeItemReader itemReader = new MultiLineTradeItemReader();

	itemReader.setDelegate(flatFileItemReader());

	return itemReader;
}

@Bean
public FlatFileItemReader flatFileItemReader() {
	FlatFileItemReader<Trade> reader = new FlatFileItemReaderBuilder<>()
			.name("flatFileItemReader")
			.resource(new ClassPathResource("data/iosample/input/multiLine.txt"))
			.lineTokenizer(orderFileTokenizer())
			.fieldSetMapper(orderFieldSetMapper())
			.build();
	return reader;
}
下面的示例展示了如何在 XML 中实现自定义的 ItemReader:
<bean id="itemReader" class="org.spr...MultiLineTradeItemReader">
    <property name="delegate">
        <bean class="org.springframework.batch.item.file.FlatFileItemReader">
            <property name="resource" value="data/iosample/input/multiLine.txt" />
            <property name="lineMapper">
                <bean class="org.spr...DefaultLineMapper">
                    <property name="lineTokenizer" ref="orderFileTokenizer"/>
                    <property name="fieldSetMapper" ref="orderFieldSetMapper"/>
                </bean>
            </property>
        </bean>
    </property>
</bean>
为了确保每一行都能正确分词,这对于固定长度的输入尤其重要,可以在委托的 FlatFileItemReader 上使用 PatternMatchingCompositeLineTokenizer。更多详情请参见读者与作家章节中的 FlatFileItemReader。然后,委托读取器使用 PassThroughFieldSetMapper 为每一行传递一个 FieldSet 回到包装的 ItemReader。
- Java
- XML
下面的示例展示了如何确保 Java 中的每一行正确地进行标记化:
@Bean
public PatternMatchingCompositeLineTokenizer orderFileTokenizer() {
	PatternMatchingCompositeLineTokenizer tokenizer =
			new PatternMatchingCompositeLineTokenizer();

	Map<String, LineTokenizer> tokenizers = new HashMap<>(4);

	tokenizers.put("HEA*", headerRecordTokenizer());
	tokenizers.put("FOT*", footerRecordTokenizer());
	tokenizers.put("NCU*", customerLineTokenizer());
	tokenizers.put("BAD*", billingAddressLineTokenizer());

	tokenizer.setTokenizers(tokenizers);

	return tokenizer;
}
下面的示例展示了如何确保 XML 中的每一行正确地进行标记化:
<bean id="orderFileTokenizer" class="org.spr...PatternMatchingCompositeLineTokenizer">
    <property name="tokenizers">
        <map>
            <entry key="HEA*" value-ref="headerRecordTokenizer" />
            <entry key="FOT*" value-ref="footerRecordTokenizer" />
            <entry key="NCU*" value-ref="customerLineTokenizer" />
            <entry key="BAD*" value-ref="billingAddressLineTokenizer" />
        </map>
    </property>
</bean>
这个包装器必须能够识别记录的结束位置,以便它可以持续对其委托对象调用 read(),直到到达结束位置。对于读取的每一行,包装器应构建要返回的项。一旦到达页脚,该项就可以被返回,以传递给 ItemProcessor 和 ItemWriter,如下例所示:
private FlatFileItemReader<FieldSet> delegate;

public Trade read() throws Exception {
    Trade t = null;

    for (FieldSet line = null; (line = this.delegate.read()) != null;) {
        String prefix = line.readString(0);
        if (prefix.equals("HEA")) {
            t = new Trade(); // Record must start with header
        }
        else if (prefix.equals("NCU")) {
            Assert.notNull(t, "No header was found.");
            t.setLast(line.readString(1));
            t.setFirst(line.readString(2));
            ...
        }
        else if (prefix.equals("BAD")) {
            Assert.notNull(t, "No header was found.");
            t.setCity(line.readString(4));
            t.setState(line.readString(6));
          ...
        }
        else if (prefix.equals("FOT")) {
            return t; // Record must end with footer
        }
    }
    Assert.isNull(t, "No 'END' was found.");
    return null;
}
执行系统命令
许多批处理作业需要在批处理作业内部调用外部命令。这样的进程可以由调度程序单独启动,但关于运行的通用元数据的优势将会丢失。此外,多步骤的作业也需要被拆分为多个作业。
由于需求非常普遍,Spring Batch 提供了一个用于调用系统命令的 Tasklet 实现。
- Java
- XML
下面的示例展示了如何在 Java 中调用外部命令:
@Bean
public SystemCommandTasklet tasklet() {
	SystemCommandTasklet tasklet = new SystemCommandTasklet();

	tasklet.setCommand("echo hello");
	tasklet.setTimeout(5000);

	return tasklet;
}
下面的示例展示了如何在 XML 中调用外部命令:
<bean class="org.springframework.batch.core.step.tasklet.SystemCommandTasklet">
    <property name="command" value="echo hello" />
    <!-- 命令完成的超时时间为 5 秒 -->
    <property name="timeout" value="5000" />
</bean>
当未找到输入时处理步骤完成
在许多批处理场景中,在数据库或文件中找不到需要处理的行并不是异常情况。Step 仅仅被视为没有找到需要处理的任务,并以读取 0 项完成。Spring Batch 提供的所有 ItemReader 实现默认采用这种方法。如果即使存在输入也没有输出,这可能会导致一些混淆(通常发生在文件被误命名或其他类似问题时)。因此,应检查元数据本身,以确定框架找到了多少需要处理的任务。然而,如果找不到输入被视为异常情况呢?在这种情况下,通过编程方式检查元数据中未处理的项目并触发失败是最佳解决方案。由于这是一个常见的用例,Spring Batch 提供了一个具有此功能的监听器,如 NoWorkFoundStepExecutionListener 的类定义所示:
public class NoWorkFoundStepExecutionListener extends StepExecutionListenerSupport {

    public ExitStatus afterStep(StepExecution stepExecution) {
        if (stepExecution.getReadCount() == 0) {
            return ExitStatus.FAILED;
        }
        return null;
    }

}
前面的 StepExecutionListener 在 'afterStep' 阶段检查 StepExecution 的 readCount 属性,以确定是否没有读取任何项。如果是这种情况,则返回退出代码 FAILED,表示该 Step 应该失败。否则,返回 null,这不会影响 Step 的状态。
传递数据到未来步骤
在很多情况下,将信息从一个步骤传递到另一个步骤是非常有用的。这可以通过 ExecutionContext 来实现。需要注意的是,存在两个 ExecutionContext:一个在 Step 级别,另一个在 Job 级别。Step 的 ExecutionContext 仅在步骤执行期间存在,而 Job 的 ExecutionContext 则在整个 Job 执行期间都存在。另一方面,每当 Step 提交一个 chunk 时,Step 的 ExecutionContext 都会更新,而 Job 的 ExecutionContext 仅在每个 Step 结束时更新。
这种分离的后果是,所有数据必须在 Step 执行时放置在 ExecutionContext 中。这样做可以确保数据在 Step 运行期间正确存储。如果将数据存储到 Job 的 ExecutionContext 中,则在 Step 执行期间不会持久化。如果 Step 失败,那么这些数据将会丢失。
public class SavingItemWriter implements ItemWriter<Object> {
    private StepExecution stepExecution;

    public void write(Chunk<? extends Object> items) throws Exception {
        // ...

        ExecutionContext stepContext = this.stepExecution.getExecutionContext();
        stepContext.put("someKey", someObject);
    }

    @BeforeStep
    public void saveStepExecution(StepExecution stepExecution) {
        this.stepExecution = stepExecution;
    }
}
为了使数据能够被后续的 Steps 使用,在步骤完成后,必须将其“提升”到 Job 的 ExecutionContext 中。Spring Batch 提供了 ExecutionContextPromotionListener 来实现这一目的。该监听器必须配置与需要提升的数据相关的 ExecutionContext 中的键。此外,还可以选择性地配置一组退出代码模式,以指定在哪些情况下发生提升(默认为 COMPLETED)。和所有监听器一样,它必须注册到 Step 上。
- Java
- XML
下面的示例展示了如何在 Java 中将步骤提升到 Job 的 ExecutionContext:
@Bean
public Job job1(JobRepository jobRepository, Step step1, Step step2) {
	return new JobBuilder("job1", jobRepository)
				.start(step1)
				.next(step2)
				.build();
}

@Bean
public Step step1(JobRepository jobRepository, PlatformTransactionManager transactionManager) {
	return new StepBuilder("step1", jobRepository)
				.<String, String>chunk(10, transactionManager)
				.reader(reader())
				.writer(savingWriter())
				.listener(promotionListener())
				.build();
}

@Bean
public ExecutionContextPromotionListener promotionListener() {
	ExecutionContextPromotionListener listener = new ExecutionContextPromotionListener();

	listener.setKeys(new String[] {"someKey"});

	return listener;
}
下面的示例展示了如何在 XML 中将步骤提升到 Job 的 ExecutionContext:
<job id="job1">
    <step id="step1">
        <tasklet>
            <chunk reader="reader" writer="savingWriter" commit-interval="10"/>
        </tasklet>
        <listeners>
            <listener ref="promotionListener"/>
        </listeners>
    </step>

    <step id="step2">
       ...
    </step>
</job>

<beans:bean id="promotionListener" class="org.spr....ExecutionContextPromotionListener">
    <beans:property name="keys">
        <list>
            <value>someKey</value>
        </list>
    </beans:property>
</beans:bean>
最后,必须从 Job ExecutionContext 中检索保存的值,如下例所示:
public class RetrievingItemWriter implements ItemWriter<Object> {
    private Object someObject;

    public void write(Chunk<? extends Object> items) throws Exception {
        // ...
    }

    @BeforeStep
    public void retrieveInterstepData(StepExecution stepExecution) {
        JobExecution jobExecution = stepExecution.getJobExecution();
        ExecutionContext jobContext = jobExecution.getExecutionContext();
        this.someObject = jobContext.get("someKey");
    }
}