AI 概念
本节描述 Spring AI 使用的核心概念。我们建议仔细阅读本节,以理解 Spring AI 实现背后的思想。
模型
AI 模型是旨在处理和生成信息的算法,通常模拟人类认知功能。通过从大型数据集中学习模式和洞察,这些模型可以进行预测、生成文本和图像或其他输出,从而增强各行业的各种应用。
AI 模型有许多不同类型,每种都适合特定的用例。虽然 ChatGPT 及其 generative AI 能力通过文本输入和输出吸引了用户,但许多模型和公司提供了多样的输入和输出。在 ChatGPT 之前,许多人对 Midjourney 和 Stable Diffusion 等文本到图像生成模型着迷。
下表根据输入和输出类型对多个模型进行了分类:

Spring AI 目前支持以语言、图像和音频作为输入和输出的模型。上一表格中的最后一行接受文本作为输入并输出数字,通常被称为 embedding text,并表示 AI 模型中使用的内部数据结构。Spring AI 支持 embeddings,以实现更高级的用例。
使 GPT 等模型与众不同之处在于其预训练特性,正如 GPT——Chat Generative Pre-trained Transformer 中的 "P" 所示。这一预训练特性将 AI 转变为一种通用开发者工具,无需广泛的机器学习或模型训练背景。
Prompts
Prompt 构成了基于语言的输入的基础,用于引导 AI 模型生成特定输出。对于熟悉 ChatGPT 的人来说,Prompt 可能看起来只是输入到对话框中并发送给 API 的文本。然而,它包含的内容远不止于此。在许多 AI 模型中,Prompt 的文本并不只是一个简单的字符串。
ChatGPT 的 API 在一个 prompt 中包含多个文本输入,每个文本输入都会被分配一个 role。例如,有 system role,它用于告诉模型应如何表现,并为交互设置上下文。还有 user role,通常是来自用户的输入。
撰写有效的 prompt 既是一门艺术,也是一门科学。ChatGPT 是为人类对话而设计的。这与使用类似 SQL 的东西来 "提问" 截然不同。人们必须像与另一个人交谈一样与 AI 模型沟通。
这种交互风格的重要性不言而喻,术语 "Prompt Engineering" 已经发展成为一个独立的学科。日益增多的技术可以有效提升 prompt 的效果。投入时间精心打磨一个 prompt 可以显著改善最终输出。
分享提示词已经成为一种社区实践,并且针对这一主题的学术研究也在积极进行中。作为一个例子,说明创建有效提示词可能会多么反直觉(例如,与 SQL 形成对比),一篇最近的研究论文发现,你可以使用的最有效提示词之一以短语 "Take a deep breath and work on this step by step." 开头。这应该能让你了解为什么语言如此重要。我们尚未完全理解如何最有效地使用这项技术的早期版本,例如 ChatGPT 3.5,更不用说正在开发的新版本了。
Prompt 模板
创建有效的 prompts 需要建立请求的上下文,并用特定于用户输入的值替换请求中的部分内容。
该过程使用传统的基于文本的模板引擎进行提示词的创建和管理。Spring AI 采用 OSS 库 StringTemplate 来实现此目的。
例如,考虑一个简单的提示模板:
Tell me a {adjective} joke about {content}.
在 Spring AI 中,prompt 模板可以类比为 Spring MVC 架构中的 "View"。会提供一个 model 对象,通常是 java.util.Map,用于填充模板中的占位符。"rendered" 字符串会成为提供给 AI 模型的 prompt 内容。
发送给模型的 prompt 的具体数据格式存在相当大的差异。prompt 最初只是简单的字符串,后来演变为包含多个 messages,其中每个 message 中的每个字符串都表示模型的一个不同角色。
Embeddings
Embeddings 是文本、图像或视频的数值表示,用于捕获输入之间的关系。
Embeddings 通过将文本、图像和视频转换为浮点数数组(称为向量)来工作。这些向量旨在捕获文本、图像和视频的语义。Embedding 数组的长度称为向量的维度。
通过计算两段文本的向量表示之间的数值距离,应用程序可以确定用于生成 embedding vectors 的对象之间的相似度。

作为一名探索 AI 的 Java 开发者,不必理解这些向量表示背后复杂的数学理论或具体实现。只要基本理解它们在 AI 系统中的作用和功能即可,尤其是在将 AI 功能集成到你的应用中时。
Embeddings 与 Retrieval Augmented Generation (RAG) 模式等实际应用尤为相关。它们能够将数据表示为语义空间中的点,这类似于欧几里得几何的 2-D 空间,但维度更高。这意味着,就像欧几里得几何中平面上的点可以根据坐标彼此靠近或远离一样,在语义空间中,点之间的接近程度反映了含义上的相似性。关于相似主题的句子在这个多维空间中彼此更靠近,就像图表上彼此靠近的点一样。这种接近性有助于文本分类、语义搜索甚至产品推荐等任务,因为它使 AI 能够根据相关概念在这个扩展语义版图中的 "location" 来识别并分组它们。
你可以将这个语义空间理解为一个向量。
Tokens
Tokens 是 AI 模型运作方式的基本构建单元。在输入时,模型将单词转换为 Tokens。在输出时,模型将 Tokens 转换回单词。
在英文中,一个 token 大约相当于 75% 的单词。作为参考,莎士比亚全集总计约 900,000 个单词,约合 120 万 tokens。

也许更重要的是,Tokens = Money。在托管 AI 模型的背景下,你的费用由使用的 token 数量决定。输入和输出都会计入整体 token 数量。
此外,模型受到 token 限制,这限制了单次 API 调用中处理的文本量。这个阈值通常被称为 "context window"。模型不会处理超出此限制的任何文本。
例如,ChatGPT3 有 4K token 限制,而 GPT4 提供不同选项,例如 8K、16K 和 32K。Anthropic 的 Claude AI 模型具有 100K token 限制,而 Meta 最近的研究产出了一个 1M token 限制的模型。
要使用 GPT4 总结莎士比亚全集,你需要设计软件工程策略来切分数据,并在模型的上下文窗口限制内呈现数据。Spring AI 项目可以帮助你完成这项任务。
结构化输出
AI 模型的传统输出结果通常会以 java.lang.String 形式返回,即使你要求回复为 JSON。它可能是一个正确的 JSON,但并不是 JSON 数据结构。它只是一个字符串。此外,在提示词中要求 “for JSON” 也并非 100% 准确。
这种复杂性催生了一个专门领域,涉及创建 prompt 以生成预期输出,随后将生成的简单字符串转换为可用于应用集成的数据结构。
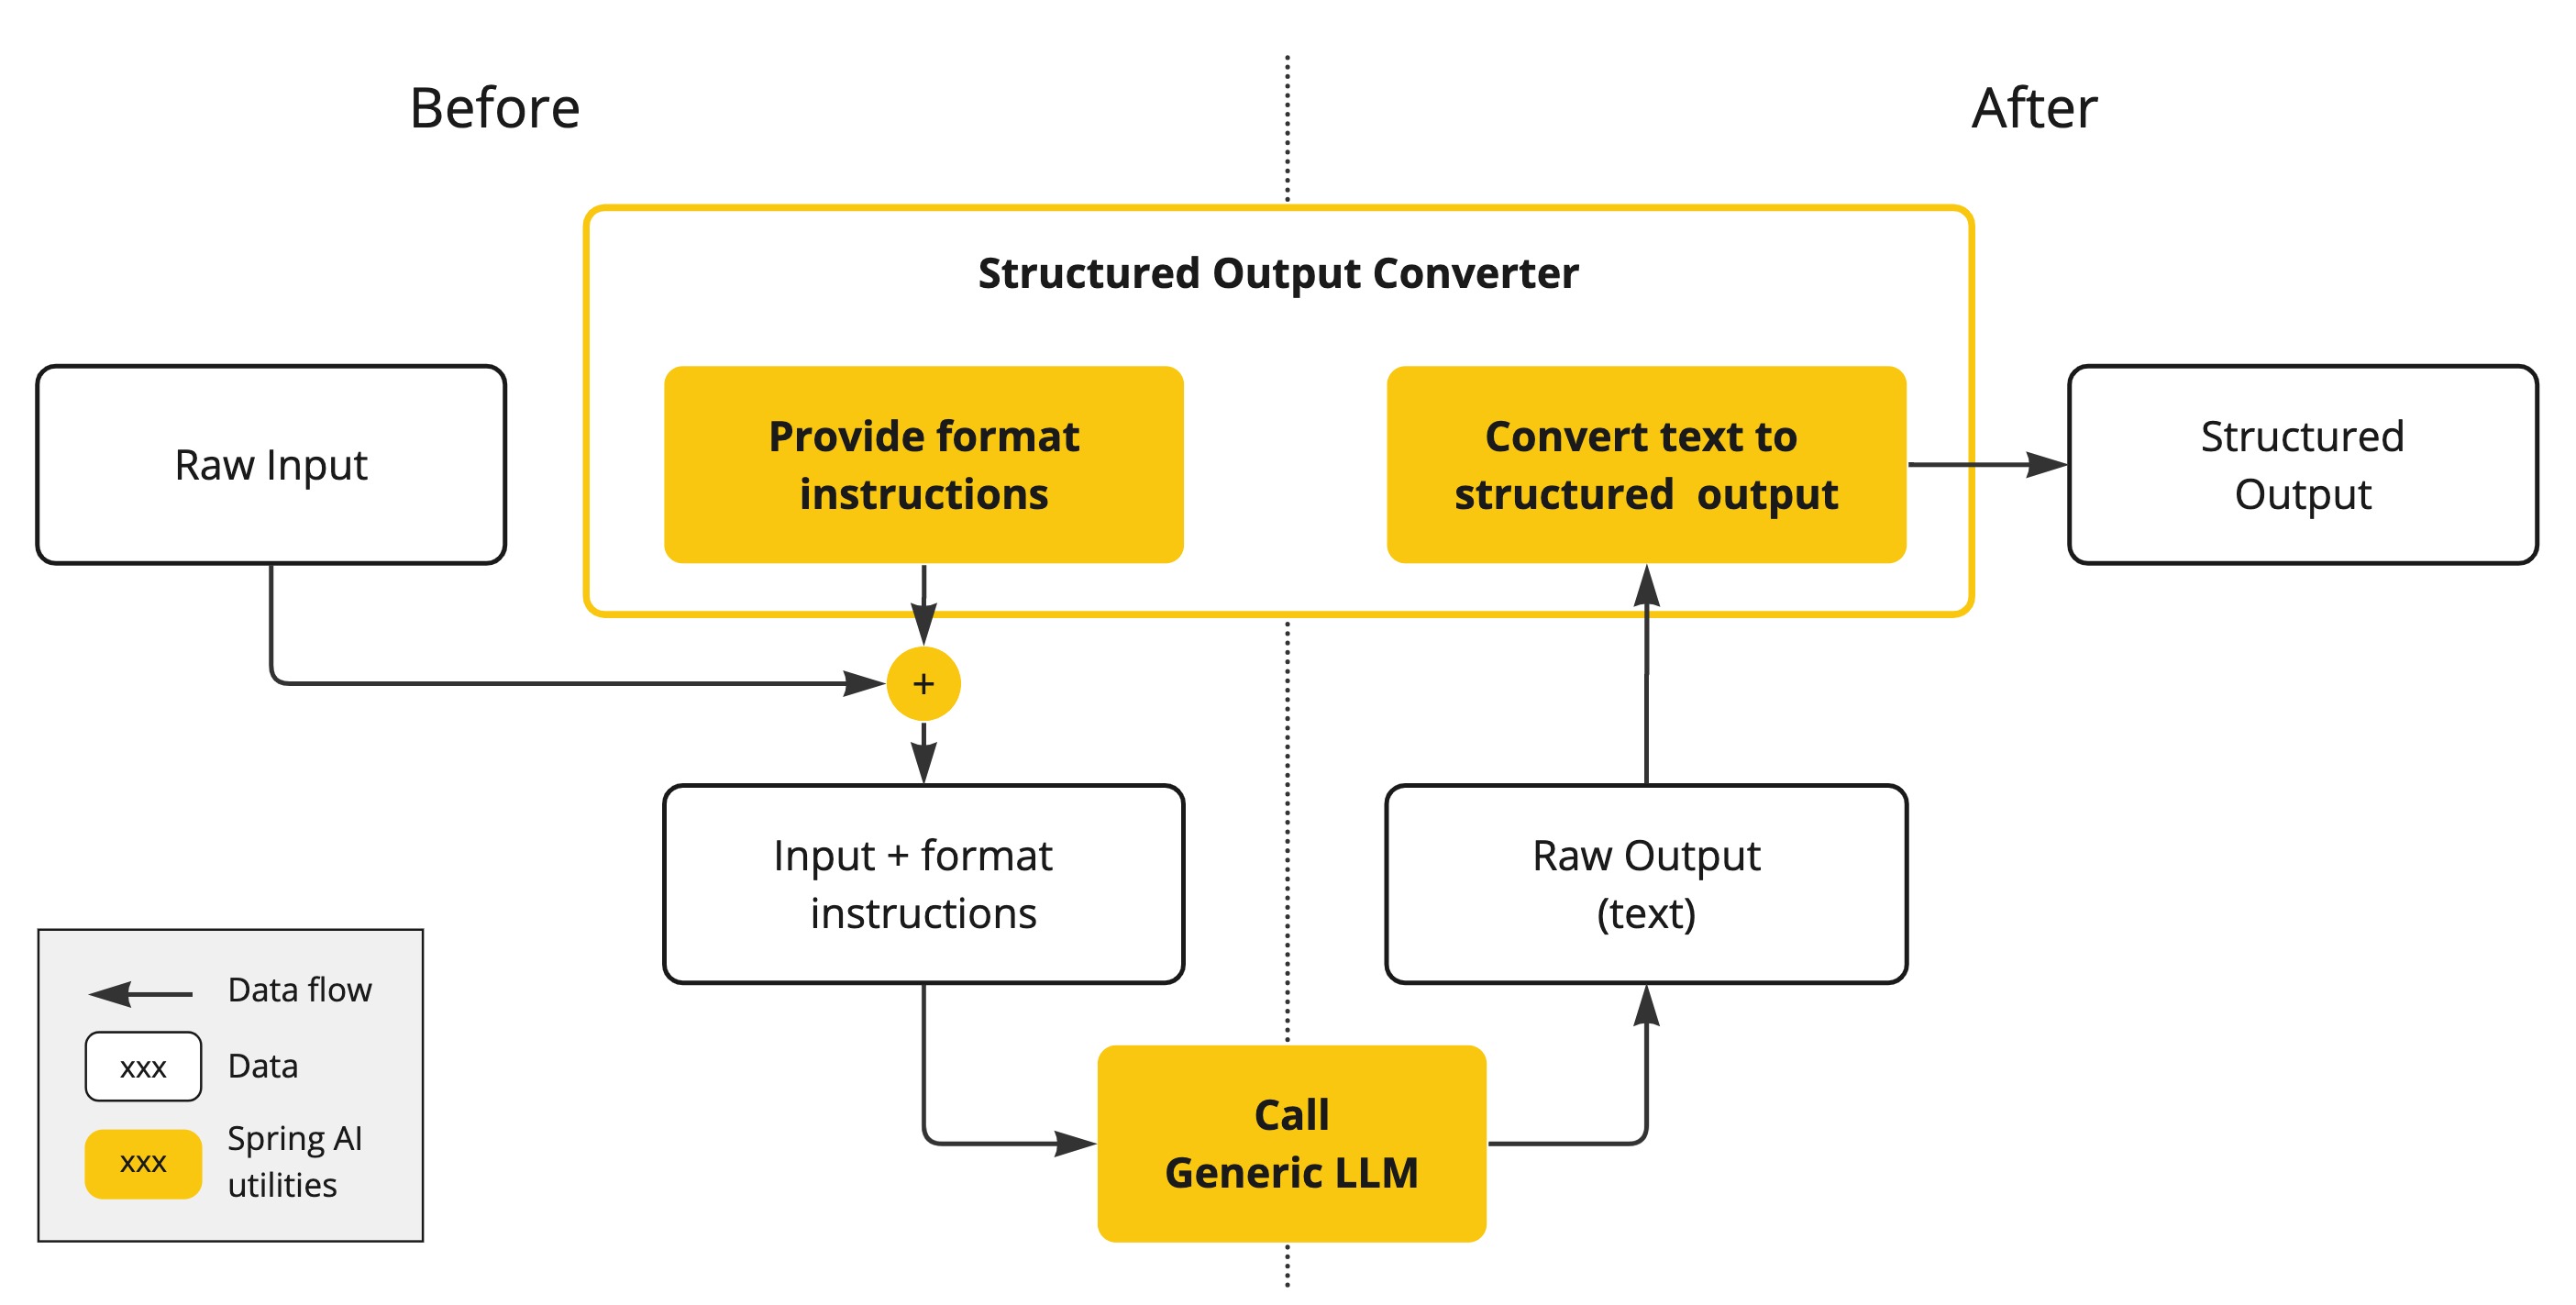
Structured output conversion 采用精心设计的提示,通常需要与模型进行多次交互,才能达到所需的格式。
将您的数据和 APIs 接入 AI 模型
如何为 AI 模型提供其未经过训练的信息?
需要注意的是,GPT 3.5/4.0 数据集仅扩展到 2021 年 9 月。因此,对于需要该日期之后知识的问题,模型会表示不知道答案。一个有趣的细节是,该数据集大约为 650GB。
有 3 种技术可用于自定义 AI 模型以纳入你的数据:
-
Fine Tuning:这种传统的机器学习技术涉及定制模型并更改其内部权重。然而,对于机器学习专家来说,这是一个具有挑战性的过程,并且由于 GPT 等模型的规模,它极其耗费资源。此外,一些模型可能不提供此选项。
-
Prompt Stuffing:一个更实用的替代方案是将你的数据嵌入到提供给模型的 prompt 中。由于模型存在 token 限制,需要一些技术在模型的 context window 内呈现相关数据。这种方法通俗地称为 "stuffing the prompt"。Spring AI 库可以帮助你实现基于 "stuffing the prompt" 技术的解决方案,也称为 Retrieval Augmented Generation (RAG)。

- Tool Calling:该技术允许注册工具(用户自定义服务),将大语言模型连接到外部系统的 API。Spring AI 大大简化了支持 tool calling 所需编写的代码。
检索增强生成
一种名为 Retrieval Augmented Generation (RAG) 的技术应运而生,用于解决将相关数据纳入提示中以获得准确 AI 模型响应的挑战。
该方法采用批处理风格的编程模型,其中作业从你的文档中读取非结构化数据,对其进行转换,然后将其写入向量数据库。从高层来看,这是一个 ETL(Extract、Transform 和 Load)流水线。向量数据库用于 RAG 技术的检索部分。
在将非结构化数据加载到 vector database 的过程中,最重要的转换之一是将原始文档拆分为更小的片段。将原始文档拆分为更小片段的过程包含两个重要步骤:
-
将文档拆分为多个部分,同时保留内容的语义边界。例如,对于包含段落和表格的文档,应避免在段落或表格中间拆分文档。对于代码,应避免在方法的实现过程中拆分代码。
-
将文档的各个部分进一步拆分为更小的部分,其大小只占 AI Model 的 token 限制的一小部分。
RAG 的下一个阶段是处理用户输入。当用户的问题要由 AI 模型回答时,该问题和所有 “similar” 的文档片段会被放入发送给 AI 模型的 prompt 中。这就是使用 vector database 的原因。它非常擅长查找相似内容。

-
ETL Pipeline 提供了有关编排从数据源提取数据并将其存储到结构化 vector store 中的流程的更多信息,以确保在将数据传递给 AI 模型时,数据处于适合检索的最佳格式。
-
ChatClient - RAG 说明了如何使用
QuestionAnswerAdvisor在应用程序中启用 RAG 能力。
Tool Calling
大型语言模型(LLMs)在训练后被冻结,导致知识过时,并且它们无法访问或修改外部数据。
Tool Calling 机制解决了这些缺点。它允许你将自己的服务注册为工具,以将大语言模型连接到外部系统的 APIs。这些系统可以为 LLMs 提供实时数据,并代表它们执行数据处理操作。
Spring AI 极大简化了支持 tool invocation 所需编写的代码。它会为你处理 tool invocation 会话。你可以将工具作为带 @Tool 注解的方法提供,并在 prompt options 中提供它,使模型可以使用该工具。此外,你可以在单个 prompt 中定义并引用多个工具。

-
当我们想让模型可以使用某个工具时,我们会在 chat request 中包含该工具的定义。每个工具定义包含一个 name、一个 description 以及输入参数的 schema。
-
当模型决定调用某个工具时,它会发送一个响应,其中包含工具 name 以及按照已定义 schema 建模的输入参数。
-
应用程序负责使用工具 name 来识别并使用提供的输入参数执行该工具。
-
工具调用的结果由应用程序处理。
-
应用程序将工具调用结果发送回模型。
-
模型使用工具调用结果作为附加上下文来生成最终响应。
有关如何在不同的 AI 模型中使用此功能的更多信息,请查阅 Tool Calling 文档。
评估 AI 响应
有效评估 AI 系统针对用户请求的输出,对于确保最终应用的准确性和实用性非常重要。一些新兴技术可以使用预训练模型本身来完成此目的。
该评估过程涉及分析生成的响应是否符合用户意图和查询上下文。会使用相关性、连贯性和事实正确性等指标来衡量 AI 生成响应的质量。
一种方法是向模型同时展示用户的请求和 AI 模型的响应,并查询该响应是否与提供的数据一致。
此外,利用存储在 vector database 中的信息作为补充数据,可以增强评估流程,帮助判断响应的相关性。
Spring AI 项目提供了 Evaluator API,目前可使用基础策略来评估模型响应。更多信息请参阅 评估测试 文档。