结构化输出
大型语言模型是文本输入、文本输出的系统。当下游代码需要根据某个字段进行路由、持久化某个值,或基于结果进行分支处理时,该文本必须转换为带类型的记录。结构化输出弥合了这一差距:模型被引导生成符合特定 schema 的文本,应用再将其解析为带类型的对象,使代码库中的其他部分可以像处理任何其他领域类型一样处理它。
Spring AI 通过 ChatClient 流式 API 中的 .entity(…) 方法直接暴露结构化输出功能。您只需定义一个 Java 类型以指定期望返回的数据结构,Spring AI 将处理其余部分:从您的类型生成 JSON Schema,指示模型遵守该 Schema,并将响应反序列化为指定的类型。
本页面介绍高层次的 ChatClient 路径。有关可靠性开关和更低层级的 API,请参阅:
-
模式校验与自我修正 — 检测格式错误的输出,并自动通过
validateSchema()进行重试。 -
提供商原生结构化输出 — 使用
useProviderStructuredOutput()在提供商 API 层面强制实施模式。 -
输出转换器 — 更底层的
StructuredOutputConverterAPI、内置转换器以及自定义/非 JSON 转换器。
类型化响应
为要返回的 shape 定义一个 Java record:
record ActorsFilms(String actor, List<String> movies) {}
让 ChatClient 进行填充。不要以 .content() 结束调用——这会返回原始文本回复——而是以 .entity(…) 结束,并传入您的目标类型:
ActorsFilms films = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class);
结果是一个类型为 ActorsFilms 的值,你可以将其传递给代码的其他部分:
films.actor();     // "Tom Hanks"
films.movies();    // ["Forrest Gump", "Cast Away", ...]
在幕后,Spring AI 做了三件事:一个 schema 生成器将你的 ActorsFilms record 转换为 JSON schema,该 schema 被追加到 prompt 的 system context 中,并且模型返回的 JSON 答案被交给一个类型转换器,将其解析回你的 record。
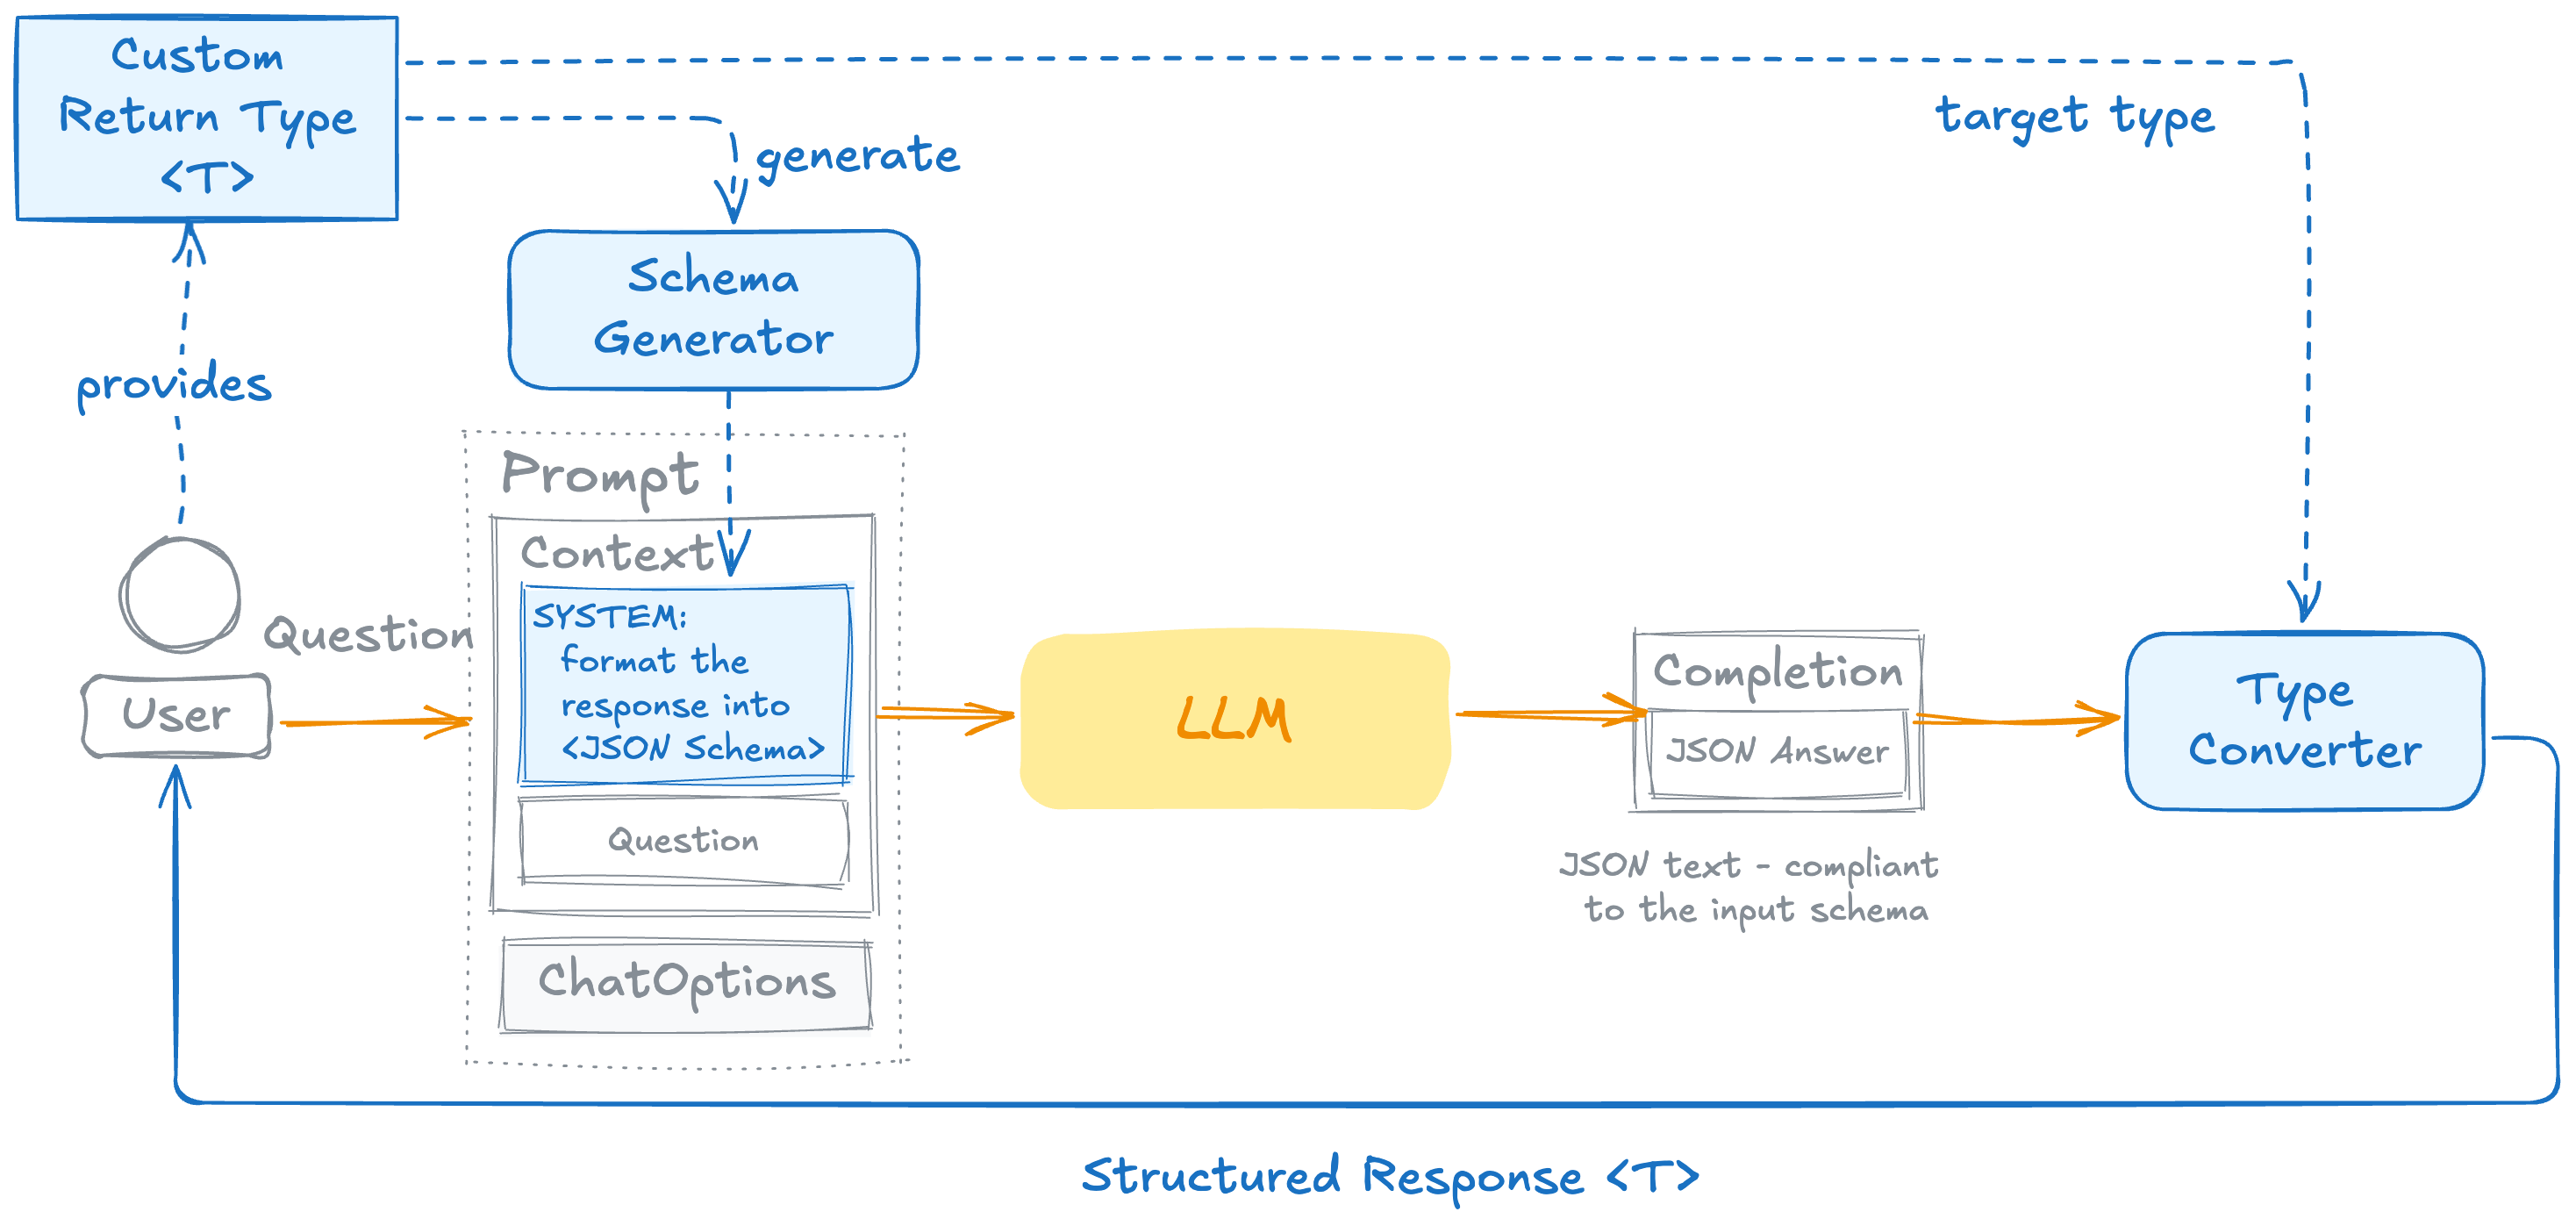
它在 Spring AI 支持的每个模型上都能正常工作——没有任何与特定提供商相关的特性。
.entity(…) 仅限在 .call() 中使用。类型化解析需要完整的响应,因此在流式路径上不可用(.stream() 返回的是文本块,而非类型化对象)。这一点适用于本页列出的所有变体——Class、ParameterizedTypeReference、自定义转换器,以及是否启用可靠性开关的情况。
默认的 .entity(…) 调用没有保证。模型被要求生成符合 schema 的 JSON,但并非被强制执行。大多数情况下它都会遵守;但有时它会返回多余的字段、遗漏必填字段,或将 JSON 包裹在自然语言文本中,导致解析器抛出异常。以下两个开关用于解决此问题。
泛型类型:列表、映射及其他
.entity(Class) 用于具体类。对于泛型类型 —— List<ActorsFilms>、Map<String, ActorsFilms> —— 请使用 ParameterizedTypeReference:
List<ActorsFilms> films = chatClient.prompt()
    .user("Generate filmographies for three random actors.")
    .call()
    .entity(new ParameterizedTypeReference<List<ActorsFilms>>() {});
可靠性开关:EntityParamSpec
所有 .entity(…)(以及 .responseEntity(…))重载均接受一个可选的 Consumer<EntityParamSpec>,该参数启用两种独立且可组合的行为。
不要因格式错误的输出而失败:validateSchema()
validateSchema() 开启了一个自纠正的重试循环:Spring AI 会针对实体的 schema 验证响应,如果验证失败,具体的错误信息会被追加到提示词中并重新发起调用 — 默认最多尝试 3 次。
ActorsFilms films = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class, spec -> spec.validateSchema());
请参阅模式验证与自我校正了解重试循环的工作方式以及如何进行自定义。
更严格的向上游保证:useProviderStructuredOutput()
useProviderStructuredOutput() 将 schema 作为 API 级约束发送给提供商,因此提供商的运行时负责强制执行规范,而不是依赖提示词中的说明。
ActorsFilms films = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class, spec -> spec.useProviderStructuredOutput());
这需要底层模型支持原生结构化输出(native structured output)。支持的提供商和限制请参见 Provider-Native Structured Output。
结合两者
这两个开关解决不同的问题,且可以自然地组合使用:
ActorsFilms films = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class, spec -> spec
        .useProviderStructuredOutput()
        .validateSchema());
useProviderStructuredOutput() 通过在 API 层面约束模型,最大限度地降低输出格式错误的可能性。validateSchema() 则捕获剩余的情况(例如:提供商的边缘案例、推理模型的特性),并自动进行纠正。当下游代码无法容忍结构变化时,应同时使用这两个函数。
获取完整响应
.entity(…) 仅返回解析后的对象。如果还需要底层的 ChatResponse —— 例如用于获取 token 使用情况、可观测性元数据,或除实体以外的其他信息 —— 请使用 .responseEntity(…):
ResponseEntity<ChatResponse, ActorsFilms> result = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .responseEntity(ActorsFilms.class);

ActorsFilms films = result.entity();
ChatResponse raw = result.response();
long totalTokens = raw.getMetadata().getUsage().getTotalTokens();
它具有与 .entity(…) 相同的重载集合——Class、ParameterizedTypeReference、自定义的 StructuredOutputConverter 以及 EntityParamSpec 消费者均适用。
自定义和非 JSON 输出
当内置的 JSON 解析功能无法满足需求——例如模型将 JSON 包裹在 Markdown 代码块中,或者你需要使用 YAML 或 CSV 等非 JSON 格式——可以将自定义的 StructuredOutputConverter<T> 传递给 .entity(…)。参见 Output Converters。
速查表
| 需求 | 使用方式 |
|---|---|
| 默认 — 适用于所有 Provider | .entity(Type.class) |
泛型类型,如 List<T>、Map<K,V> | .entity(new ParameterizedTypeReference<…>() {}) |
| 输出格式错误时不抛出异常 | .entity(Type.class, spec → spec.validateSchema()) |
| 更强的 Provider 上游结构化输出保证 | .entity(Type.class, spec → spec.useProviderStructuredOutput()) |
| 两者兼得 — 请求约束 + 响应重试 | .entity(Type.class, spec → spec.useProviderStructuredOutput().validateSchema()) |
| 在实体同时获取 Token 使用情况 / 元数据 | .responseEntity(…)(重载方法相同) |
| 模型将 JSON 包裹在 markdown 围栏中,或非 JSON 格式 | 实现 StructuredOutputConverter<T> 并将其传入 .entity(…) |
| 流式响应 | 不支持 — .entity(…) 仅限 .call();.stream() 返回文本块而非类型化对象 |
结构化输出是尽力将模型输出转换为结构化类型的最佳尝试。不保证模型会返回所请求的结构。当正确性至关重要时,请使用 validateSchema() 和/或 useProviderStructuredOutput()。
StructuredOutputConverter 不用于 LLM 工具调用(Tool Calling),因为该功能默认即提供结构化输出。
章节总结
模式校验与自我修正
默认的 .entity(…) 调用要求模型生成符合 schema 的 JSON,但无法强制其遵守。当模型返回额外字段、遗漏必需字段,或将 JSON 包裹在文本中时,解析器会抛出异常。
提供商原生结构化输出
默认情况下,.entity(…) 会将 JSON Schema 作为文本指令追加到提示中。这是一种响应端的方法:要求模型遵循该指令,随后再对响应进行解析。
输出转换器
高级 .entity(…) API 建立在 StructuredOutputConverter 抽象之上。大多数应用无需直接操作它。当您需要做到以下几点时,请考虑使用这一更底层的 API: