多模态 API
"All things that are naturally connected ought to be taught in combination" - John Amos Comenius, "Orbis Sensualium Pictus", 1658
人类会同时通过多种数据输入模态来处理知识。我们的学习方式和体验都是多模态的。我们并非只有视觉、音频和文本。
与这些原则相反,Machine Learning 通常专注于为处理单一模态而定制的模型。例如,我们为文本转语音或语音转文本等任务开发了音频模型,并为对象检测和分类等任务开发了计算机视觉模型。
然而,一波新的多模态大语言模型开始出现。示例包括 OpenAI 的 GPT、Google 的 Gemini、Anthropic 的 Claude,以及开源产品 Llama、LLaVA 和 BakLLaVA,它们能够接受多种输入,包括文本、图像、音频和视频,并通过整合这些输入生成文本响应。
多模态大型语言模型 (LLM) 功能使模型能够结合图像、音频或视频等其他模态来处理和生成文本。
Spring AI 多模态
Multimodality 指的是模型同时理解和处理来自各种来源的信息的能力,包括文本、图像、音频和其他数据格式。
Spring AI Message API 提供了支持多模态 LLM 所需的全部抽象。
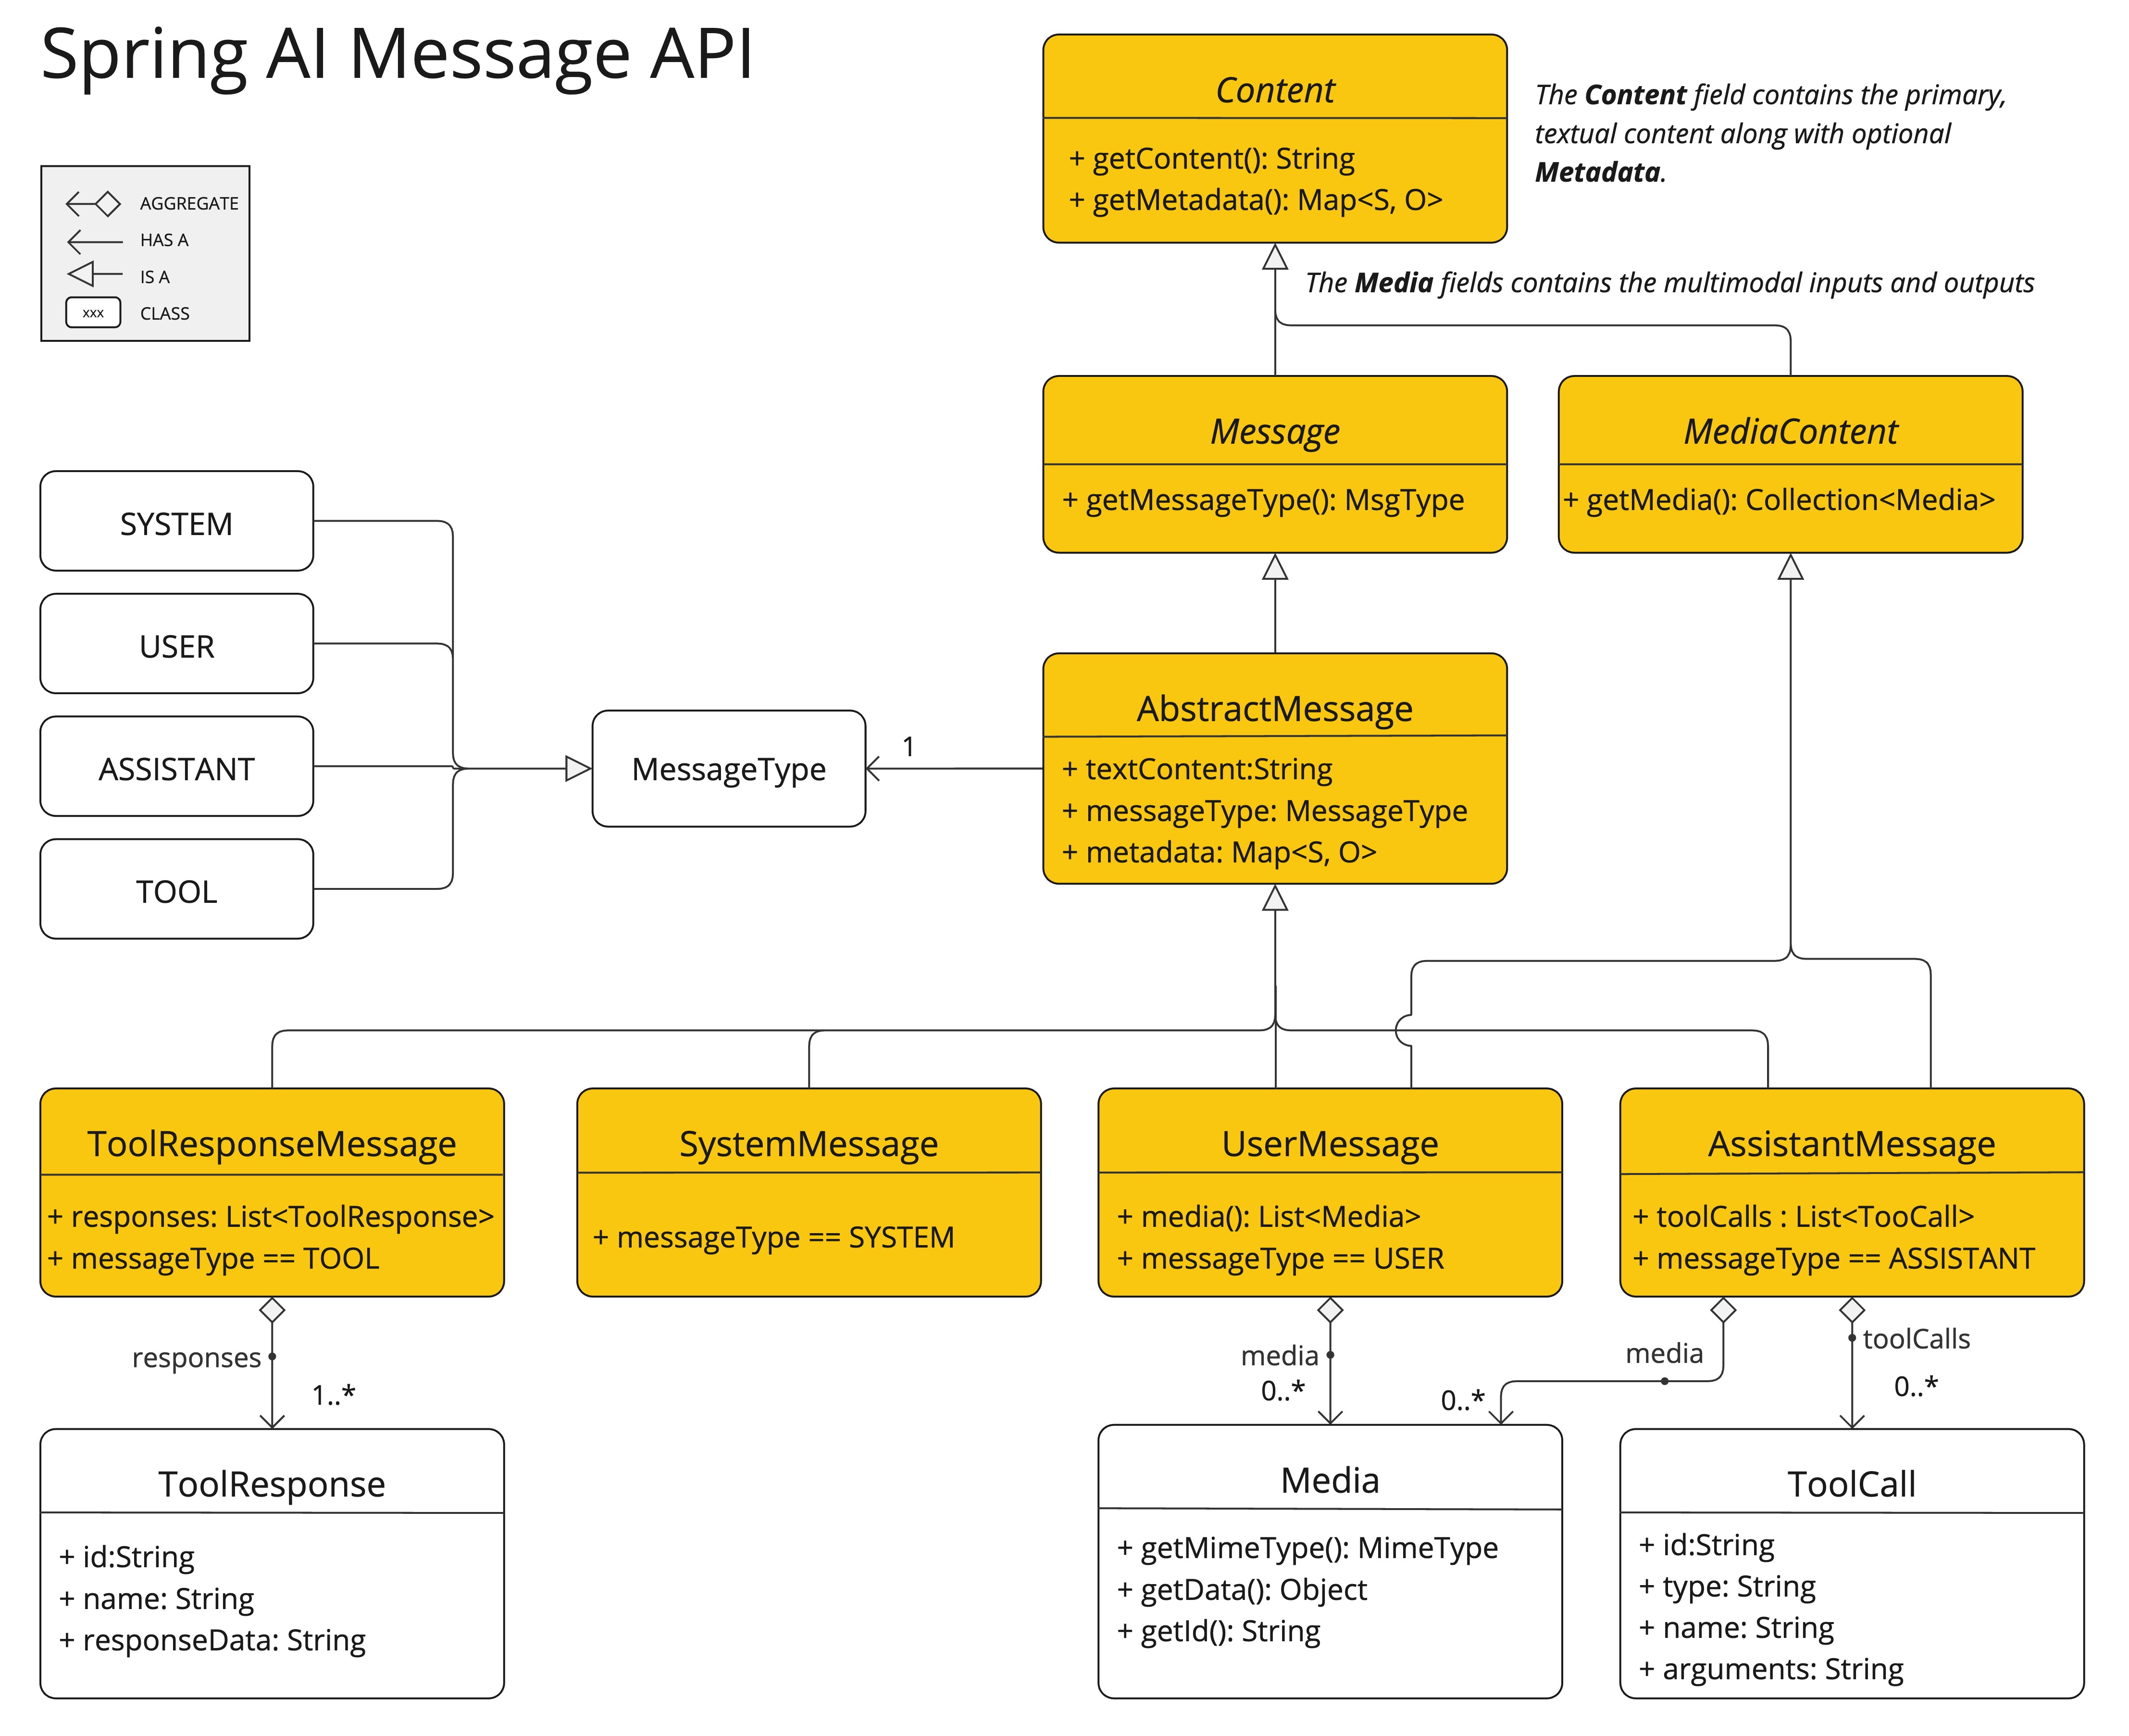
UserMessage 的 content 字段主要用于文本输入,而可选的 media 字段允许添加一个或多个不同模态的附加内容,例如图像、音频和视频。MimeType 指定模态类型。根据所使用的 LLM,Media 数据字段可以是作为 Resource 对象的原始媒体内容,也可以是指向该内容的 URI。
media 字段目前仅适用于用户输入消息(例如 UserMessage)。它对系统消息没有意义。包含 LLM 响应的 AssistantMessage 仅提供文本内容。要生成非文本媒体输出,应使用专用的单模态模型。*
例如,我们可以将下面的图片 (multimodal.test.png) 作为输入,并要求 LLM 解释它所看到的内容。

对于大多数 multimodal LLMs,Spring AI 代码通常如下所示:
var imageResource = new ClassPathResource("/multimodal.test.png");

var userMessage = UserMessage.builder()
    .text("Explain what do you see in this picture?") // content
    .media(new Media(MimeTypeUtils.IMAGE_PNG, this.imageResource)) // media
    .build();

ChatResponse response = chatModel.call(new Prompt(this.userMessage));
或者使用流畅的 ChatClient API:
String response = ChatClient.create(chatModel).prompt()
		.user(u -> u.text("Explain what do you see on this picture?")
				    .media(MimeTypeUtils.IMAGE_PNG, new ClassPathResource("/multimodal.test.png")))
		.call()
		.content();
并生成类似以下的响应:
这是一张设计简约的水果碗图片。该碗由金属制成,弯曲的金属丝边缘形成了开放式结构,使水果可以从各个角度清晰可见。碗内放着 2 根黄色香蕉,它们搁在看起来像是 1 个红苹果的上面。香蕉略微熟透,果皮上的褐色斑点表明了这一点。碗顶部有一个金属环,可能用作提携的把手。碗放置在一个平坦表面上,背景为中性色调,可清晰呈现碗内的水果。
Spring AI 为以下聊天模型提供多模态支持: