ETL 流水线
Extract, Transform, and Load (ETL) 框架是 Retrieval Augmented Generation (RAG) 用例中数据处理的支柱。
ETL pipeline 负责编排从原始数据源到结构化 vector store 的数据流,确保数据处于适合 AI 模型检索的最优格式。
RAG 用例是文本,用于通过从数据集中检索相关信息来增强生成模型的能力,以提升生成输出的质量和相关性。
API 概览
ETL 管道创建、转换并存储 Document 实例。
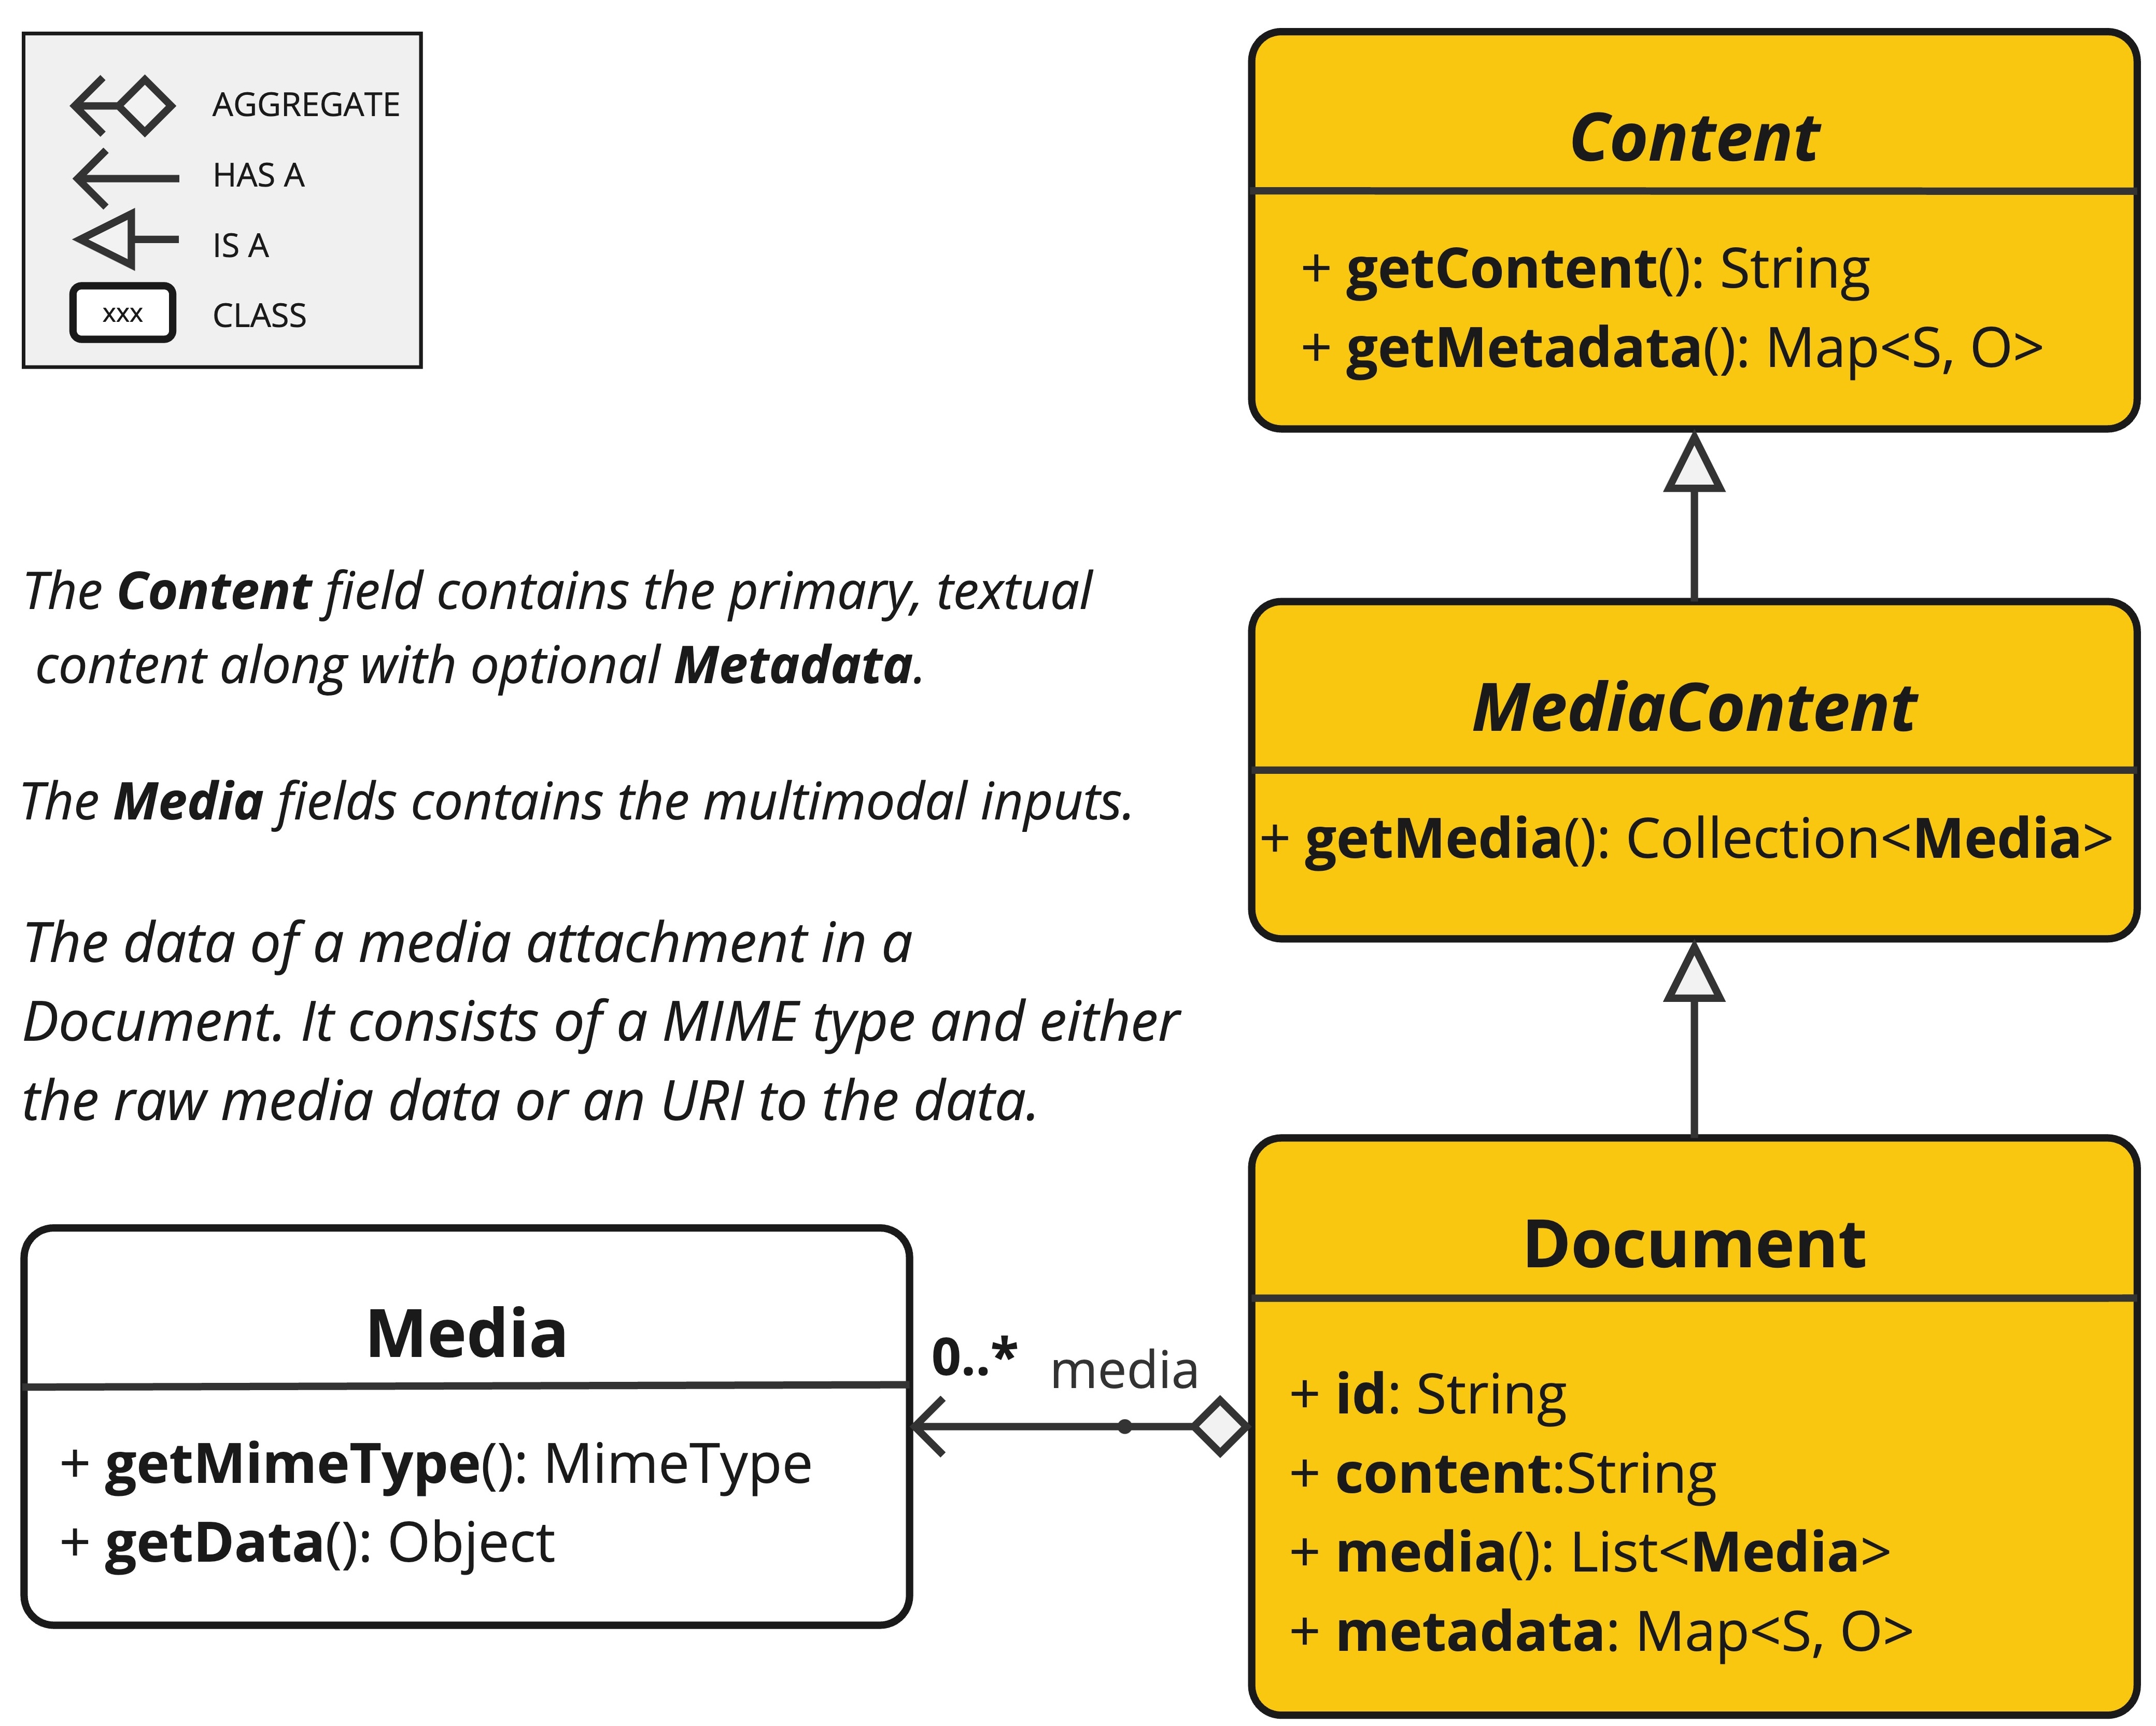
Document 类包含文本、元数据以及可选的其他媒体类型,例如图像、音频和视频。
ETL pipeline 有三个主要组件,
-
DocumentReader实现Supplier<List<Document>> -
DocumentTransformer实现Function<List<Document>, List<Document>> -
DocumentWriter实现Consumer<List<Document>>
Document 类的内容借助 DocumentReader 从 PDF、文本文件和其他文档类型创建。
要构建一个简单的 ETL pipeline,你可以将每种类型的一个实例串联起来。

假设我们有以下这 3 种 ETL 类型的实例
-
PagePdfDocumentReader是DocumentReader的一个实现 -
TokenTextSplitter是DocumentTransformer的一个实现 -
VectorStore是DocumentWriter的一个实现
要将数据基本加载到 Vector Database 中以供 Retrieval Augmented Generation 模式使用,请使用以下 Java 函数风格语法的代码。
vectorStore.accept(tokenTextSplitter.apply(pdfReader.get()));
或者,你可以使用对该领域更自然、更有表现力的方法名。
vectorStore.write(tokenTextSplitter.split(pdfReader.read()));
ETL 接口
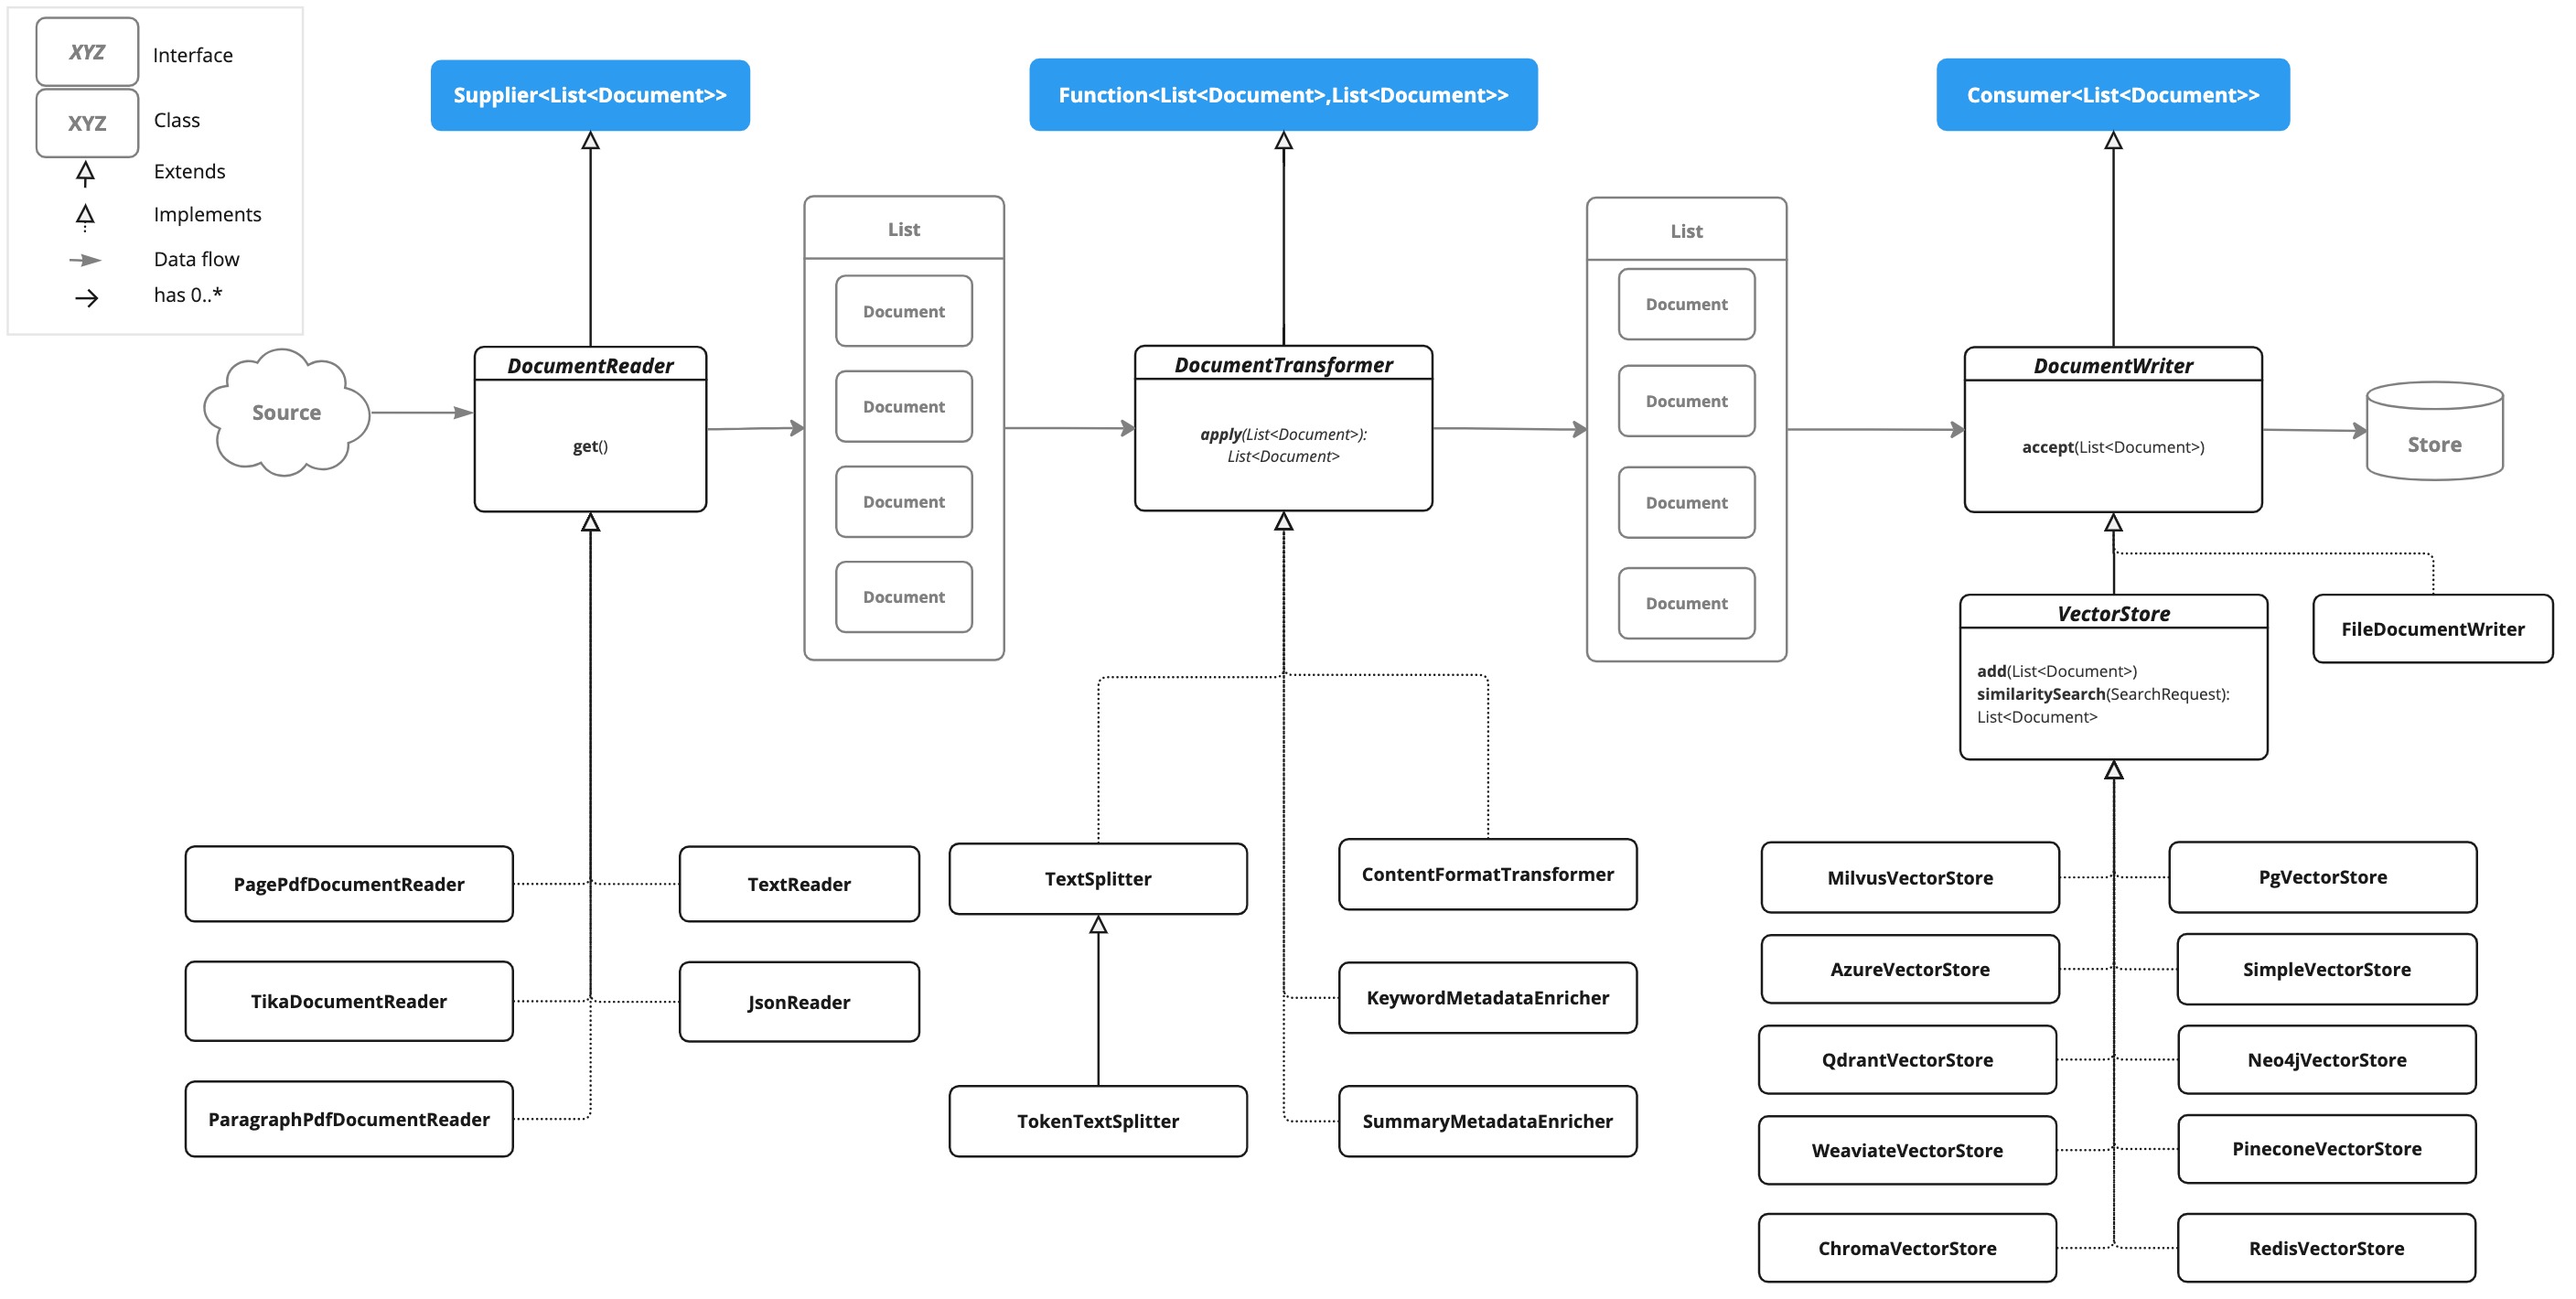
ETL 管道由以下接口和实现组成。详细的 ETL 类图显示在 ETL 类图 部分。
DocumentReader
提供来自不同来源的文档源。
public interface DocumentReader extends Supplier<List<Document>> {

    default List<Document> read() {
		return get();
	}
}
DocumentTransformer
作为处理工作流的一部分,转换一批文档。
public interface DocumentTransformer extends Function<List<Document>, List<Document>> {

    default List<Document> transform(List<Document> transform) {
		return apply(transform);
	}
}
DocumentWriter
管理 ETL 流程的最后阶段,为存储准备文档。
public interface DocumentWriter extends Consumer<List<Document>> {

    default void write(List<Document> documents) {
		accept(documents);
	}
}
ETL 类图
以下类图展示了 ETL 接口和实现。
DocumentReaders
下面描述的大多数 DocumentReader 和 DocumentWriter 实现都是使用 Resource 或资源模式构造的,并在内部使用 DefaultResourceLoader 或其变体来访问存储。应注意不要直接使用用户提供的 URL 构造此类实例,因为这涉及安全影响。
JSON
JsonReader 处理 JSON 文档,将其转换为 Document 对象列表。
示例
@Component
class MyJsonReader {

	private final Resource resource;

    MyJsonReader(@Value("classpath:bikes.json") Resource resource) {
        this.resource = resource;
    }

	List<Document> loadJsonAsDocuments() {
        JsonReader jsonReader = new JsonReader(this.resource, "description", "content");
        return jsonReader.get();
	}
}
构造函数选项
JsonReader 提供了多个构造函数选项:
-
JsonReader(Resource resource) -
JsonReader(Resource resource, String… jsonKeysToUse) -
JsonReader(Resource resource, JsonMetadataGenerator jsonMetadataGenerator, String… jsonKeysToUse)
参数
-
resource: 一个指向 JSON 文件的 SpringResource对象。 -
jsonKeysToUse: 来自 JSON 的键数组,应将其用作生成的Document对象中的文本内容。 -
jsonMetadataGenerator: 可选的JsonMetadataGenerator,用于为每个Document创建 metadata。
行为
JsonReader 处理 JSON 内容的方式如下:
-
它可以处理 JSON 数组和单个 JSON 对象。
-
对于每个 JSON 对象(无论是数组中的对象还是单个对象):
-
它根据指定的
jsonKeysToUse提取内容。 -
如果未指定键,则将整个 JSON 对象作为内容。
-
它使用提供的
JsonMetadataGenerator生成元数据(如果未提供,则生成空的元数据)。 -
它会创建一个包含提取内容和元数据的
Document对象。
-
使用 JSON Pointers
JsonReader 现在支持使用 JSON Pointer 检索 JSON 文档的特定部分。该功能使你可以轻松地从复杂的 JSON 结构中提取嵌套数据。
get(String pointer) 方法
public List<Document> get(String pointer)
该方法允许你使用 JSON Pointer 来检索 JSON 文档的特定部分。
参数
pointer:一个 JSON Pointer 字符串(如 RFC 6901 中所定义),用于在 JSON 结构中定位所需元素。
返回值
- 返回一个
List<Document>,其中包含从指针所定位的 JSON 元素中解析出的文档。
行为
-
该方法使用提供的 JSON Pointer 导航到 JSON 结构中的特定位置。
-
如果指针有效且指向现有元素:
-
对于 JSON 对象:返回包含单个 Document 的列表。
-
对于 JSON 数组:返回 Document 列表,数组中的每个元素对应一个 Document。
-
-
如果指针无效或指向不存在的元素,则抛出
IllegalArgumentException。
示例
JsonReader jsonReader = new JsonReader(resource, "description");
List<Document> documents = this.jsonReader.get("/store/books/0");
示例 JSON 结构
[
  {
    "id": 1,
    "brand": "Trek",
    "description": "A high-performance mountain bike for trail riding."
  },
  {
    "id": 2,
    "brand": "Cannondale",
    "description": "An aerodynamic road bike for racing enthusiasts."
  }
]
在这个示例中,如果将 JsonReader 配置为使用 "description" 作为 jsonKeysToUse,它将创建 Document 对象,其中内容为数组中每辆自行车的 "description" 字段的值。
备注
-
JsonReader使用 Jackson 进行 JSON 解析。 -
它可以高效处理大型 JSON 文件,通过对数组使用流式处理。
-
如果在
jsonKeysToUse中指定了多个键,内容将是这些键对应值的拼接结果。 -
该读取器很灵活,可以通过自定义
jsonKeysToUse和JsonMetadataGenerator来适配各种 JSON 结构。
文本
TextReader 处理纯文本文档,将其转换为 Document 对象列表。
示例
@Component
class MyTextReader {

    private final Resource resource;

    MyTextReader(@Value("classpath:text-source.txt") Resource resource) {
        this.resource = resource;
    }

	List<Document> loadText() {
		TextReader textReader = new TextReader(this.resource);
		textReader.getCustomMetadata().put("filename", "text-source.txt");

		return textReader.read();
    }
}
构造函数选项
TextReader 提供两个构造函数选项:
-
TextReader(String resourceUrl) -
TextReader(Resource resource)
参数
-
resourceUrl:表示要读取的资源 URL 的字符串。 -
resource:指向文本文件的 SpringResource对象。
配置
-
setCharset(Charset charset): 设置用于读取文本文件的字符集。默认为 UTF-8。 -
getCustomMetadata(): 返回一个可变 Map,你可以在其中为文档添加自定义元数据。
行为
TextReader 处理文本内容如下:
-
它将文本文件的全部内容读取到单个
Document对象中。 -
文件的内容成为
Document的内容。 -
元数据会自动添加到
Document:-
charset:用于读取文件的字符集(默认:"UTF-8")。 -
source:源文本文件的文件名。
-
-
通过
getCustomMetadata()添加的任何自定义元数据都会包含在Document中。
注意事项
-
TextReader会将整个文件内容读入内存,因此可能不适合非常大的文件。 -
如果你需要将文本拆分为更小的块,可以在读取文档后使用类似
TokenTextSplitter的文本拆分器:
List<Document> documents = textReader.get();
List<Document> splitDocuments = TokenTextSplitter.builder().build().apply(this.documents);
-
该 reader 使用 Spring 的
Resource抽象,使其能够从各种来源(classpath、文件系统、URL 等)读取。 -
可以使用
getCustomMetadata()方法向该 reader 创建的所有文档添加自定义元数据。
HTML (JSoup)
JsoupDocumentReader 使用 JSoup 库处理 HTML 文档,将其转换为 Document 对象列表。
依赖
使用 Maven 或 Gradle 将依赖添加到你的项目中。
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-jsoup-document-reader</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-jsoup-document-reader'
}
示例
@Component
class MyHtmlReader {

    private final Resource resource;

    MyHtmlReader(@Value("classpath:/my-page.html") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadHtml() {
        JsoupDocumentReaderConfig config = JsoupDocumentReaderConfig.builder()
            .selector("article p") // Extract paragraphs within <article> tags
            .charset("ISO-8859-1")  // Use ISO-8859-1 encoding
            .includeLinkUrls(true) // Include link URLs in metadata
            .metadataTags(List.of("author", "date")) // Extract author and date meta tags
            .additionalMetadata("source", "my-page.html") // Add custom metadata
            .build();

        JsoupDocumentReader reader = new JsoupDocumentReader(this.resource, config);
        return reader.get();
    }
}
JsoupDocumentReaderConfig 允许你自定义 JsoupDocumentReader 的行为:
-
charset: 指定 HTML 文档的字符编码(默认为 "UTF-8")。 -
selector: 一个 JSoup CSS 选择器,用于指定要从哪些元素中提取文本(默认为 "body")。 -
separator: 用于连接多个选定元素的文本的字符串(默认为 "\n")。 -
allElements: 如果为true,则从<body>元素中提取所有文本,忽略selector(默认为false)。 -
groupByElement: 如果为true,则为每个与selector匹配的元素创建一个单独的Document(默认为false)。 -
includeLinkUrls: 如果为true,则提取绝对链接 URL 并将其添加到元数据中(默认为false)。 -
metadataTags: 要从中提取内容的<meta>标签名称列表(默认为["description", "keywords"])。 -
additionalMetadata: 允许你向所有创建的Document对象添加自定义元数据。
示例文档: my-page.html
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>My Web Page</title>
<meta name="description" content="A sample web page for Spring AI">
<meta name="keywords" content="spring, ai, html, example">
<meta name="author" content="John Doe">
<meta name="date" content="2024-01-15">
<link rel="stylesheet" href="style.css">
</head>
<body>
<header>
<h1>Welcome to My Page</h1>
</header>
<nav>
<ul>
<li><a href="/">Home</a></li>
<li><a href="/about">About</a></li>
</ul>
</nav>
<article>
<h2>Main Content</h2>
<p>This is the main content of my web page.</p>
<p>It contains multiple paragraphs.</p>
<a href="https://www.example.com">External Link</a>
</article>
<footer>
<p>© 2024 John Doe</p>
</footer>
</body>
</html>
行为:
JsoupDocumentReader 处理 HTML 内容,并根据配置创建 Document 对象:
-
selector决定使用哪些元素进行文本提取。 -
如果
allElements为true,则<body>内的所有文本会被提取到一个Document中。 -
如果
groupByElement为true,则每个匹配selector的元素都会创建一个单独的Document。 -
如果
allElements和groupByElement都不为true,则所有匹配selector的元素中的文本会使用separator进行拼接。 -
文档标题、来自指定
<meta>标签的内容,以及(可选)链接 URL,会被添加到Document元数据中。 -
用于解析相对链接的 base URI 将从 URL 资源中提取。
reader 保留所选元素的文本内容,但会移除其中的所有 HTML 标签。
Markdown
MarkdownDocumentReader 处理 Markdown 文档,将其转换为 Document 对象列表。
依赖项
使用 Maven 或 Gradle 将依赖添加到你的项目中。
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-markdown-document-reader</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-markdown-document-reader'
}
示例
@Component
class MyMarkdownReader {

    private final Resource resource;

    MyMarkdownReader(@Value("classpath:code.md") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadMarkdown() {
        MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder()
            .withHorizontalRuleCreateDocument(true)
            .withIncludeCodeBlock(false)
            .withIncludeBlockquote(false)
            .withAdditionalMetadata("filename", "code.md")
            .build();

        MarkdownDocumentReader reader = new MarkdownDocumentReader(this.resource, config);
        return reader.get();
    }
}
MarkdownDocumentReaderConfig 允许你自定义 MarkdownDocumentReader 的行为:
-
horizontalRuleCreateDocument:当设置为true时,Markdown 中的水平分割线将创建新的Document对象。 -
includeCodeBlock:当设置为true时,代码块将与周围文本包含在同一个Document中。当设置为false时,代码块会创建单独的Document对象。 -
includeBlockquote:当设置为true时,引用块将与周围文本包含在同一个Document中。当设置为false时,引用块会创建单独的Document对象。 -
additionalMetadata:允许你向所有创建的Document对象添加自定义元数据。
示例文档: code.md
This is a Java sample application:

```java
package com.example.demo;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
public class DemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(DemoApplication.class, args);
    }
}
```

Markdown also provides the possibility to `use inline code formatting throughout` the entire sentence.

---

Another possibility is to set block code without specific highlighting:

```
./mvnw spring-javaformat:apply
```
行为:MarkdownDocumentReader 处理 Markdown 内容,并根据配置创建 Document 对象:
-
标题会成为 Document objects 中的元数据。
-
段落会成为 Document objects 的内容。
-
代码块可以拆分为独立的 Document objects,也可以包含在周围的文本中。
-
块引用可以拆分为独立的 Document objects,也可以包含在周围的文本中。
-
水平分割线可用于将内容拆分为独立的 Document objects。
读取器保留 Document 对象内容中的格式,例如行内代码、列表和文本样式。
PDF 页面
PagePdfDocumentReader 使用 Apache PdfBox 库来解析 PDF 文档。
依赖项
使用 Maven 或 Gradle 将依赖添加到你的项目中。
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-pdf-document-reader'
}
示例
@Component
public class MyPagePdfDocumentReader {

	List<Document> getDocsFromPdf() {

		PagePdfDocumentReader pdfReader = new PagePdfDocumentReader("classpath:/sample1.pdf",
				PdfDocumentReaderConfig.builder()
					.withPageTopMargin(0)
					.withPageExtractedTextFormatter(ExtractedTextFormatter.builder()
						.withNumberOfTopTextLinesToDelete(0)
						.build())
					.withPagesPerDocument(1)
					.build());

		return pdfReader.read();
    }

}
PDF 段落
ParagraphPdfDocumentReader 使用 PDF catalog(例如 TOC)信息将输入 PDF 拆分为文本段落,并为每个段落输出单个 Document。注意:并非所有 PDF 文档都包含 PDF catalog。
依赖
使用 Maven 或 Gradle 将依赖添加到你的项目中。
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-pdf-document-reader'
}
示例
@Component
public class MyPagePdfDocumentReader {

	List<Document> getDocsFromPdfWithCatalog() {

        ParagraphPdfDocumentReader pdfReader = new ParagraphPdfDocumentReader("classpath:/sample1.pdf",
                PdfDocumentReaderConfig.builder()
                    .withPageTopMargin(0)
                    .withPageExtractedTextFormatter(ExtractedTextFormatter.builder()
                        .withNumberOfTopTextLinesToDelete(0)
                        .build())
                    .withPagesPerDocument(1)
                    .build());

	    return pdfReader.read();
    }
}
Tika (DOCX, PPTX, HTML…)
TikaDocumentReader 使用 Apache Tika 从多种文档格式中提取文本,例如 PDF、DOC/DOCX、PPT/PPTX 和 HTML。有关支持格式的完整列表,请参阅 Tika 文档。
依赖项
使用 Maven 或 Gradle 将依赖添加到你的项目中。
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-tika-document-reader</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-tika-document-reader'
}
示例
@Component
class MyTikaDocumentReader {

    private final Resource resource;

    MyTikaDocumentReader(@Value("classpath:/word-sample.docx")
                            Resource resource) {
        this.resource = resource;
    }

    List<Document> loadText() {
        TikaDocumentReader tikaDocumentReader = new TikaDocumentReader(this.resource);
        return tikaDocumentReader.read();
    }
}
Transformers
TextSplitter
TextSplitter 是一个抽象基类,用于帮助拆分文档,以适应 AI 模型的上下文窗口。
TokenTextSplitter
TokenTextSplitter 是 TextSplitter 的一种实现,它根据 token 数量将文本拆分为块。它支持可配置的编码类型(例如 CL100K_BASE、P50K_BASE、O200K_BASE),默认使用 CL100K_BASE。
用法
基本用法
@Component
class MyTokenTextSplitter {

    public List<Document> splitDocuments(List<Document> documents) {
        TokenTextSplitter splitter = TokenTextSplitter.builder().build();
        return splitter.apply(documents);
    }

    public List<Document> splitCustomized(List<Document> documents) {
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(1000)
            .withMinChunkSizeChars(400)
            .withMinChunkLengthToEmbed(10)
            .withMaxNumChunks(5000)
            .withKeepSeparator(true)
            .build();
        return splitter.apply(documents);
    }
}
自定义编码类型
你可以配置用于 tokenization 的编码类型。这在使用不同 tokenizers 的模型时非常有用:
TokenTextSplitter splitter = TokenTextSplitter.builder()
    .withEncodingType(EncodingType.O200K_BASE)
    .withChunkSize(1000)
    .build();
自定义标点符号
你可以自定义用于将文本拆分为语义上有意义的文本块的标点符号。这对于国际化特别有用:
@Component
class MyInternationalTextSplitter {

    public List<Document> splitChineseText(List<Document> documents) {
        // Use Chinese punctuation marks
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(800)
            .withMinChunkSizeChars(350)
            .withPunctuationMarks(List.of('。', '?', '!', ';'))  // Chinese punctuation
            .build();

        return splitter.apply(documents);
    }

    public List<Document> splitWithCustomMarks(List<Document> documents) {
        // Mix of English and other punctuation marks
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(800)
            .withPunctuationMarks(List.of('.', '?', '!', '\n', ';', ':', '。'))
            .build();

        return splitter.apply(documents);
    }
}
配置
使用 TokenTextSplitter.builder() 创建实例。所有构造函数均已弃用,请改用 builder。
参数
-
encodingType:要使用的分词器编码类型(默认值为CL100K_BASE)。支持的值包括CL100K_BASE、P50K_BASE和O200K_BASE。 -
chunkSize:每个文本块的目标大小,以 token 为单位(默认值为 800)。 -
minChunkSizeChars:每个文本块的最小大小,以字符为单位(默认值为 350)。 -
minChunkLengthToEmbed:要包含的块的最小长度(默认值为 5)。 -
maxNumChunks:从文本生成的最大块数(默认值为 10000)。 -
keepSeparator:是否在块中保留分隔符(如换行符)(默认值为 true)。 -
punctuationMarks:用于分割时作为句子边界的字符列表(默认值为.、?、!、\n)。
行为
TokenTextSplitter 处理文本内容的过程如下:
-
它使用 CL100K_BASE 编码将输入文本编码为 tokens。
-
它根据
chunkSize将编码后的文本拆分为多个块。 -
对于每个块:
-
它将该块解码回文本。
-
仅当总 token 数超过块大小,它会尝试在
minChunkSizeChars之后找到一个合适的断点(使用配置的punctuationMarks)。 -
如果找到断点,它会在该点处截断该块。
-
它会修剪该块,并根据
keepSeparator设置可选地移除换行符。 -
如果生成的块长于
minChunkLengthToEmbed,则将其添加到输出中。
-
-
此过程会持续进行,直到所有 tokens 都被处理完毕或达到
maxNumChunks。 -
如果剩余文本长于
minChunkLengthToEmbed,则会作为最后一个块添加。
基于标点的拆分仅在 token 数量超过 chunk size 时应用。恰好等于或小于 chunk size 的文本会作为单个 chunk 返回,不会进行基于标点的截断。这可避免对小文本进行不必要的拆分。
示例
Document doc1 = new Document("This is a long piece of text that needs to be split into smaller chunks for processing.",
        Map.of("source", "example.txt"));
Document doc2 = new Document("Another document with content that will be split based on token count.",
        Map.of("source", "example2.txt"));

TokenTextSplitter splitter = TokenTextSplitter.builder().build();
List<Document> splitDocuments = splitter.apply(List.of(doc1, doc2));

for (Document doc : splitDocuments) {
    System.out.println("Chunk: " + doc.getContent());
    System.out.println("Metadata: " + doc.getMetadata());
}
说明
-
TokenTextSplitter使用jtokkit库中的 CL100K_BASE 编码,该编码与较新的 OpenAI 模型兼容。 -
该拆分器会尽可能在句子边界处断开,以创建语义上有意义的文本块。
-
原始文档中的元数据会被保留,并复制到所有由该文档派生的文本块中。
-
如果
copyContentFormatter设置为true(默认行为),原始文档中的内容格式化器(如果已设置)也会被复制到派生的文本块中。 -
该拆分器对于为具有 token 限制的大型语言模型准备文本特别有用,可确保每个文本块都在模型的处理能力范围内。
-
自定义标点符号:默认标点符号(
.、?、!、\n)适用于英文文本。对于其他语言或专业内容,请使用构建器的withPunctuationMarks()方法自定义标点符号。 -
性能注意事项:虽然该拆分器可以处理任意数量的标点符号,但为了获得最佳性能,建议将列表保持在合理较小的范围(少于 20 个字符),因为每个标点符号都会针对每个文本块进行检查。
-
可扩展性:
getLastPunctuationIndex(String)方法是protected,允许子类重写标点符号检测逻辑,以用于特殊用例。 -
小文本处理:从 2.0 版本开始,小文本(token 数量小于或等于文本块大小的文本)不再按标点符号拆分,从而避免对已符合大小限制的内容进行不必要的碎片化。
ContentFormatTransformer
确保所有文档中的内容格式统一。
KeywordMetadataEnricher
KeywordMetadataEnricher 是一个 DocumentTransformer,它使用生成式 AI 模型从文档内容中提取关键词,并将其作为元数据添加。
用法
@Component
class MyKeywordEnricher {

    private final ChatModel chatModel;

    MyKeywordEnricher(ChatModel chatModel) {
        this.chatModel = chatModel;
    }

    List<Document> enrichDocuments(List<Document> documents) {
        KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
                .keywordCount(5)
                .build();

        // Or use custom templates
        KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
               .keywordsTemplate(YOUR_CUSTOM_TEMPLATE)
               .build();

        return enricher.apply(documents);
    }
}
构造函数选项
KeywordMetadataEnricher 提供了两个构造函数选项:
-
KeywordMetadataEnricher(ChatModel chatModel, int keywordCount):使用默认模板并提取指定数量的关键词。 -
KeywordMetadataEnricher(ChatModel chatModel, PromptTemplate keywordsTemplate):使用自定义模板进行关键词提取。
行为
KeywordMetadataEnricher 处理文档的流程如下:
-
对于每个输入文档,它使用文档内容创建一个 prompt。
-
它将此 prompt 发送到提供的
ChatModel以生成关键词。 -
生成的关键词会被添加到文档元数据中的 "excerpt_keywords" 键下。
-
返回增强后的文档。
自定义
你可以使用默认模板,或通过 keywordsTemplate 参数自定义模板。默认模板为:
\{context_str}. Give %s unique keywords for this document. Format as comma separated. Keywords:
其中 {context_str} 会被替换为文档内容,%s 会被替换为指定的关键词数量。
示例
ChatModel chatModel = // initialize your chat model
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
                .keywordCount(5)
                .build();

// Or use custom templates
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
                .keywordsTemplate(new PromptTemplate("Extract 5 important keywords from the following text and separate them with commas:\n{context_str}"))
                .build();

Document doc = new Document("This is a document about artificial intelligence and its applications in modern technology.");

List<Document> enrichedDocs = enricher.apply(List.of(this.doc));

Document enrichedDoc = this.enrichedDocs.get(0);
String keywords = (String) this.enrichedDoc.getMetadata().get("excerpt_keywords");
System.out.println("Extracted keywords: " + keywords);
笔记
-
KeywordMetadataEnricher需要一个正常工作的ChatModel来生成关键词。 -
关键词数量必须为 1 或更大。
-
该 enricher 会为每个处理后的文档添加 "excerpt_keywords" metadata 字段。
-
生成的关键词会以逗号分隔的字符串形式返回。
-
该 enricher 对于提升文档可搜索性,以及为文档生成标签或类别特别有用。
-
在 Builder 模式中,如果设置了
keywordsTemplate参数,则会忽略keywordCount参数。
SummaryMetadataEnricher
SummaryMetadataEnricher 是一个 DocumentTransformer,它使用生成式 AI 模型为文档创建摘要,并将其添加为 metadata。它可以为当前文档以及相邻文档(前一个和后一个)生成摘要。
用法
@Configuration
class EnricherConfig {

    @Bean
    public SummaryMetadataEnricher summaryMetadata(OpenAiChatModel aiClient) {
        return new SummaryMetadataEnricher(aiClient,
            List.of(SummaryType.PREVIOUS, SummaryType.CURRENT, SummaryType.NEXT));
    }
}

@Component
class MySummaryEnricher {

    private final SummaryMetadataEnricher enricher;

    MySummaryEnricher(SummaryMetadataEnricher enricher) {
        this.enricher = enricher;
    }

    List<Document> enrichDocuments(List<Document> documents) {
        return this.enricher.apply(documents);
    }
}
构造函数
SummaryMetadataEnricher 提供了两个构造函数:
-
SummaryMetadataEnricher(ChatModel chatModel, List<SummaryType> summaryTypes) -
SummaryMetadataEnricher(ChatModel chatModel, List<SummaryType> summaryTypes, String summaryTemplate, MetadataMode metadataMode)
参数
-
chatModel:用于生成摘要的 AI 模型。 -
summaryTypes:SummaryType枚举值列表,指示要生成哪些摘要(PREVIOUS、CURRENT、NEXT)。 -
summaryTemplate:用于生成摘要的自定义模板(可选)。 -
metadataMode:指定在生成摘要时如何处理文档元数据(可选)。
行为
SummaryMetadataEnricher 处理文档的流程如下:
-
对于每个输入文档,它使用该文档的内容和指定的摘要模板创建一个 prompt。
-
它将此 prompt 发送到提供的
ChatModel以生成摘要。 -
根据指定的
summaryTypes,它会向每个文档添加以下元数据:-
section_summary: 当前文档的摘要。 -
prev_section_summary: 上一个文档的摘要(如果可用且被请求)。 -
next_section_summary: 下一个文档的摘要(如果可用且被请求)。
-
-
返回增强后的文档。
自定义
可以通过提供自定义 summaryTemplate 来自定义摘要生成提示。默认模板为:
"""
Here is the content of the section:
{context_str}

Summarize the key topics and entities of the section.

Summary:
"""
示例
ChatModel chatModel = // initialize your chat model
SummaryMetadataEnricher enricher = new SummaryMetadataEnricher(chatModel,
    List.of(SummaryType.PREVIOUS, SummaryType.CURRENT, SummaryType.NEXT));

Document doc1 = new Document("Content of document 1");
Document doc2 = new Document("Content of document 2");

List<Document> enrichedDocs = enricher.apply(List.of(this.doc1, this.doc2));

// Check the metadata of the enriched documents
for (Document doc : enrichedDocs) {
    System.out.println("Current summary: " + doc.getMetadata().get("section_summary"));
    System.out.println("Previous summary: " + doc.getMetadata().get("prev_section_summary"));
    System.out.println("Next summary: " + doc.getMetadata().get("next_section_summary"));
}
提供的示例演示了预期行为:
-
对于包含两个文档的列表,两个文档都会获得一个
section_summary。 -
第一个文档会获得
next_section_summary,但没有prev_section_summary。 -
第二个文档会获得
prev_section_summary,但没有next_section_summary。 -
第一个文档的
section_summary与第二个文档的prev_section_summary匹配。 -
第一个文档的
next_section_summary与第二个文档的section_summary匹配。
笔记
-
SummaryMetadataEnricher需要一个正常运行的ChatModel来生成摘要。 -
该 enricher 可以处理任意大小的文档列表,并妥善处理第一个和最后一个文档的边界情况。
-
该 enricher 对于创建上下文感知摘要特别有用,有助于更好地理解序列中的文档关系。
-
MetadataMode参数允许控制如何将现有元数据纳入摘要生成过程。
作者
文件
FileDocumentWriter 是一个 DocumentWriter 实现,用于将一组 Document 对象的内容写入文件。
用法
@Component
class MyDocumentWriter {

    public void writeDocuments(List<Document> documents) {
        FileDocumentWriter writer = new FileDocumentWriter("output.txt", true, MetadataMode.ALL, false);
        writer.accept(documents);
    }
}
构造函数
FileDocumentWriter 提供三个构造函数:
-
FileDocumentWriter(String fileName) -
FileDocumentWriter(String fileName, boolean withDocumentMarkers) -
FileDocumentWriter(String fileName, boolean withDocumentMarkers, MetadataMode metadataMode, boolean append)
参数
-
fileName: 要写入文档的文件名。 -
withDocumentMarkers: 是否在输出中包含文档标记(默认:false)。 -
metadataMode: 指定要写入文件的文档内容(默认:MetadataMode.NONE)。 -
append: 如果为 true,数据将写入文件末尾而不是开头(默认:false)。
行为
FileDocumentWriter 处理文档的方式如下:
-
它为指定文件名打开一个 FileWriter。
-
对于输入列表中的每个文档:
-
如果
withDocumentMarkers为 true,它会写入一个包含文档索引和页码的文档标记。 -
它会根据指定的
metadataMode写入该文档的格式化内容。
-
-
在所有文档写入完成后关闭文件。
文档标记
当 withDocumentMarkers 设置为 true 时,writer 会为每个文档包含以下格式的标记:
### Doc: [index], pages:[start_page_number,end_page_number]
元数据处理
writer 使用两个特定的 metadata key:
-
page_number: 表示文档的起始页码。 -
end_page_number: 表示文档的结束页码。
这些用于编写文档标记。
示例
List<Document> documents = // initialize your documents
FileDocumentWriter writer = new FileDocumentWriter("output.txt", true, MetadataMode.ALL, true);
writer.accept(documents);
这将把所有文档写入 "output.txt",包括文档标记,使用所有可用的 metadata,并且如果文件已存在则追加写入该文件。
注意事项
-
该 writer 使用
FileWriter,因此它会使用操作系统的默认字符编码写入文本文件。 -
如果在写入过程中发生错误,将抛出
RuntimeException,并将原始异常作为其原因。 -
metadataMode参数允许控制如何将现有元数据合并到写入内容中。 -
该 writer 对于调试或创建文档集合的人类可读输出特别有用。
VectorStore
提供与各种向量存储的集成。完整列表请参见 向量数据库文档。