聊天客户端 API
ChatClient 提供了一种流式 API,用于与 AI 模型进行通信。它同时支持同步和流式编程模型。
请参阅文档底部的 实现说明,其中涉及在 ChatClient 中同时使用命令式编程模型和响应式编程模型的相关内容。
流式 API(Fluent API)提供了用于构建 Prompt 组成部分的方法,该 Prompt 作为输入传递给 AI 模型。Prompt 包含指导 AI 模型输出和行为所需的指令文本。从 API 的角度来看,Prompt 由一组消息(message)组成。
AI 模型处理两种主要类型的消息:用户消息,即来自用户的直接输入;以及系统消息,由系统生成以引导对话。
这些消息通常包含占位符,运行时会根据用户输入进行替换,从而定制 AI 模型对用户输入的回答。
此外,还可以指定一些提示(Prompt)选项,例如要使用的 AI 模型名称,以及控制生成输出随机性或创造性的温度(temperature)设置。
创建 ChatClient
使用 ChatClient.Builder 对象创建 ChatClient。你可以通过 Spring Boot 自动配置获取任意 ChatModel 的 ChatClient.Builder 实例,也可以以编程方式创建一个。
使用自动配置的 ChatClient.Builder
在最简单的用例中,Spring AI 提供了 Spring Boot 自动配置,为你创建一个原型的 ChatClient.Builder Bean,以便你将其注入到类中。下面是一个简单示例,展示了如何获取针对简单用户请求的 String 响应。
@RestController
class MyController {

    private final ChatClient chatClient;

    public MyController(ChatClient.Builder chatClientBuilder) {
        this.chatClient = chatClientBuilder.build();
    }

    @GetMapping("/ai")
    String generation(String userInput) {
        return this.chatClient.prompt()
            .user(userInput)
            .call()
            .content();
    }
}
在这个简单的示例中,用户输入将设置用户消息的内容。call() 方法会向 AI 模型发送请求,而 content() 方法则以 String 形式返回 AI 模型的响应。
处理多个聊天模型
在单一应用中,你可能需要在以下几种场景下与多个聊天模型进行交互:
-
针对不同类型的任务使用不同的模型(例如,使用功能强大的模型进行复杂推理,使用更快、更便宜的模型处理更简单的任务)
-
当某个模型服务不可用时,实施回退机制
-
对不同模型或配置进行 A/B 测试
-
根据用户偏好提供多种模型选择
-
组合使用专用模型(一个用于代码生成,另一个用于创意内容等)
默认情况下,Spring AI 会自动配置一个 ChatClient.Builder bean。然而,您的应用中可能需要处理多个聊天模型。以下是处理此场景的方法:
使用单一模型类型的多个 ChatClient
本节介绍了一种常见的使用场景:您需要创建多个 ChatClient 实例,这些实例都使用相同的底层模型类型,但具有不同的配置。您可以直接使用自动配置的 ChatClient.Builder,因为它是原型(prototype)作用域的,这意味着每次注入时都会创建一个新的实例:
@Configuration
class ChatClientConfig {

    @Bean
    ChatClient defaultChatClient(ChatClient.Builder builder) {
        return builder.build();
    }

    @Bean
    ChatClient customChatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a helpful assistant.").build();
    }
}
适用于不同模型类型的 ChatClients
在同时使用多个 AI 模型时,你可能会倾向于通过 ChatClient.create(chatModel) 或 ChatClient.builder(chatModel) 分别定义独立的 ChatClient Bean。然而,这样做会绕过自动配置的 ChatClient.Builder,意味着可观测性以及 ChatClientBuilderCustomizer Bean 会被忽略。
为了保留可观测性和自定义器,您应注入 ChatClientBuilderConfigurer 以创建自定义构建器。ChatClientBuilderConfigurer 会应用所有已注册的 ChatClientBuilderCustomizer Bean 并配置可观测性,其作用与自动配置在内部执行的操作一致。
当应用上下文中存在多个 ChatModel Bean 时,Spring 无法无歧义地解析自动配置的 ChatClient.Builder Bean 的 ChatModel 依赖项。要解决这个问题,您可以将其中一个 ChatClient Bean 标记为 @Primary。如果您手动定义了它们,可能还需要将其中一个 ChatModel Bean 标记为 @Primary,或者定义您自己的 ChatClient.Builder Bean 以覆盖自动配置的 Bean。
import io.micrometer.observation.ObservationRegistry;
import org.springframework.ai.anthropic.AnthropicChatModel;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.ToolCallingAdvisor;
import org.springframework.ai.chat.client.advisor.observation.AdvisorObservationConvention;
import org.springframework.ai.chat.client.observation.ChatClientObservationConvention;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.ai.model.chat.client.autoconfigure.ChatClientBuilderConfigurer;
import org.springframework.ai.openai.OpenAiChatModel;
import org.springframework.beans.factory.ObjectProvider;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Primary;

@Configuration
public class ChatClientConfig {

    @Bean
    @Primary
    public ChatClient openAiChatClient(OpenAiChatModel chatModel, ChatClientBuilderConfigurer configurer,
            ObjectProvider<ObservationRegistry> observationRegistry,
            ObjectProvider<ChatClientObservationConvention> chatClientObservationConvention,
            ObjectProvider<AdvisorObservationConvention> advisorObservationConvention,
            ObjectProvider<ToolCallingAdvisor.Builder<?>> toolCallingAdvisorBuilder) {
        return buildChatClient(chatModel, configurer, observationRegistry,
                chatClientObservationConvention, advisorObservationConvention, toolCallingAdvisorBuilder);
    }

    @Bean
    public ChatClient anthropicChatClient(AnthropicChatModel chatModel, ChatClientBuilderConfigurer configurer,
            ObjectProvider<ObservationRegistry> observationRegistry,
            ObjectProvider<ChatClientObservationConvention> chatClientObservationConvention,
            ObjectProvider<AdvisorObservationConvention> advisorObservationConvention,
            ObjectProvider<ToolCallingAdvisor.Builder<?>> toolCallingAdvisorBuilder) {
        return buildChatClient(chatModel, configurer, observationRegistry,
                chatClientObservationConvention, advisorObservationConvention, toolCallingAdvisorBuilder);
    }

    private ChatClient buildChatClient(ChatModel chatModel, ChatClientBuilderConfigurer configurer,
            ObjectProvider<ObservationRegistry> observationRegistry,
            ObjectProvider<ChatClientObservationConvention> chatClientObservationConvention,
            ObjectProvider<AdvisorObservationConvention> advisorObservationConvention,
            ObjectProvider<ToolCallingAdvisor.Builder<?>> toolCallingAdvisorBuilder) {
        ChatClient.Builder builder = ChatClient.builder(chatModel,
                observationRegistry.getIfUnique(() -> ObservationRegistry.NOOP),
                chatClientObservationConvention.getIfUnique(),
                advisorObservationConvention.getIfUnique(),
                toolCallingAdvisorBuilder.getIfAvailable());
        return configurer.configure(builder).build();
    }
}
然后,您可以使用 @Qualifier 注解将这些 bean 注入到应用程序组件中:
@Configuration
public class ChatClientExample {

    @Bean
    CommandLineRunner cli(
            @Qualifier("openAiChatClient") ChatClient openAiChatClient,
            @Qualifier("anthropicChatClient") ChatClient anthropicChatClient) {

        return args -> {
            var scanner = new Scanner(System.in);
            ChatClient chat;

            // Model selection
            System.out.println("\nSelect your AI model:");
            System.out.println("1. OpenAI");
            System.out.println("2. Anthropic");
            System.out.print("Enter your choice (1 or 2): ");

            String choice = scanner.nextLine().trim();

            if (choice.equals("1")) {
                chat = openAiChatClient;
                System.out.println("Using OpenAI model");
            } else {
                chat = anthropicChatClient;
                System.out.println("Using Anthropic model");
            }

            // Use the selected chat client
            System.out.print("\nEnter your question: ");
            String input = scanner.nextLine();
            String response = chat.prompt(input).call().content();
            System.out.println("ASSISTANT: " + response);

            scanner.close();
        };
    }
}
多个 OpenAI 兼容 API 端点
你可以使用各自的 builder 创建多个 OpenAiChatModel 实例,以连接不同的 OpenAI 兼容 API。当你需要同时处理多个提供商时,这一点尤其有用。
@Service
public class MultiModelService {

    private static final Logger logger = LoggerFactory.getLogger(MultiModelService.class);

    public void multiClientFlow() {
        try {
            // Create a new OpenAiChatModel for Groq (Llama3)
            OpenAiChatModel groqModel = OpenAiChatModel.builder()
                .options(OpenAiChatOptions.builder()
                    .baseUrl("https://api.groq.com/openai/v1")
                    .apiKey(System.getenv("GROQ_API_KEY"))
                    .model("llama3-70b-8192")
                    .temperature(0.5)
                    .build())
                .build();

            // Create a new OpenAiChatModel for GPT-4
            OpenAiChatModel gpt4Model = OpenAiChatModel.builder()
                .options(OpenAiChatOptions.builder()
                    .baseUrl("https://api.openai.com")
                    .apiKey(System.getenv("OPENAI_API_KEY"))
                    .model("gpt-4")
                    .temperature(0.7)
                    .build())
                .build();

            // Simple prompt for both models
            String prompt = "What is the capital of France?";

            String groqResponse = ChatClient.builder(groqModel).build().prompt(prompt).call().content();
            String gpt4Response = ChatClient.builder(gpt4Model).build().prompt(prompt).call().content();

            logger.info("Groq (Llama3) response: {}", groqResponse);
            logger.info("OpenAI GPT-4 response: {}", gpt4Response);
        }
        catch (Exception e) {
            logger.error("Error in multi-client flow", e);
        }
    }
}
ChatClient Fluent API
使用 ChatClient 流式 API,您可以通过重载的 prompt 方法以三种不同方式创建提示,以启动流式 API:
-
prompt():此方法不带参数,允许你开始使用流畅 API(fluent API),以便构建提示(prompt)的用户、系统及其他部分。 -
prompt(Prompt prompt):此方法接受一个Prompt参数,允许你传入使用非流畅 API 创建的Prompt实例。 -
prompt(String content):这是一个便捷的便捷方法,与前面的重载方法类似。它接受用户的文本内容。
ChatClient 响应
ChatClient API 通过流畅 API 提供了多种方式,用于格式化来自 AI 模型的响应。
返回 ChatResponse
AI 模型返回的响应是一个由类型 [ChatResponse](../chatmodel/index.md#ChatResponse) 定义的丰富结构。它包含关于响应生成方式的元数据,并且还可以包含多个被称为 Generations 的响应,每个响应都拥有自己的元数据。元数据包括用于创建响应的 token 数量(每个 token 大约相当于 3/4 个单词)。这一信息非常重要,因为托管的 AI 模型会根据每次请求所使用的 token 数量进行计费。
下面通过调用 call() 方法后的 chatResponse() 方法,展示了一个返回包含元数据的 ChatResponse 对象的示例。
ChatResponse chatResponse = chatClient.prompt()
    .user("Tell me a joke")
    .call()
    .chatResponse();
返回实体
通常,你希望返回一个由返回的 String 映射而来的实体类。entity() 方法提供了此功能。
例如,给定一个 Java 记录:
record ActorFilms(String actor, List<String> movies) {}
您可以轻松使用 entity() 方法将 AI 模型的输出映射到该记录,如下所示:
ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorFilms.class);
此外,还有一个重载的 entity 方法,其签名为 entity(ParameterizedTypeReference<T> type),允许你指定诸如泛型 List 等类型:
List<ActorFilms> actorFilms = chatClient.prompt()
    .user("Generate the filmography of 5 movies for Tom Hanks and Bill Murray.")
    .call()
    .entity(new ParameterizedTypeReference<List<ActorFilms>>() {});
可靠性开关:EntityParamSpec
所有 entity() 重载都接受一个可选的 Consumer<EntityParamSpec>,该参数可实现两个独立的、可组合的行为:
-
validateSchema()— 根据实体模式验证 JSON 响应,并在验证失败时自动重试并提供错误反馈。 -
useProviderStructuredOutput()— 将模式作为 API 级约束发送给提供商,而非作为提示词文本。
ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorFilms.class, spec -> spec
        .useProviderStructuredOutput()
        .validateSchema());
有关这些开关、受支持的提供商、限制以及底层转换器 API 的完整详细信息,请参阅 结构化输出 参考文档。
流式响应
stream() 方法可用于获取异步响应,如下所示:
Flux<String> output = chatClient.prompt()
    .user("Tell me a joke")
    .stream()
    .content();
你还可以通过 Flux<ChatResponse> chatResponse() 方法以流式方式传输 ChatResponse。
在未来,我们将提供一个便捷方法,允许你通过响应式 stream() 方法返回 Java 实体。在此之前,你应该使用 Structured Output Converter 将聚合响应显式进行转换,如下所示。这也演示了流式 API 中参数的使用,相关细节将在文档的后续章节中进一步讨论。
var converter = new BeanOutputConverter<>(new ParameterizedTypeReference<List<ActorsFilms>>() {});

Flux<String> flux = this.chatClient.prompt()
    .user(u -> u.text("""
                        Generate the filmography for a random actor.
                        {format}
                      """)
            .param("format", this.converter.getFormat()))
    .stream()
    .content();

String content = this.flux.collectList().block().stream().collect(Collectors.joining());

List<ActorsFilms> actorFilms = this.converter.convert(this.content);
提示词模板
ChatClient 流式 API 允许你将用户文本和系统文本作为带有变量的模板提供,这些变量会在运行时被替换。
String answer = ChatClient.create(chatModel).prompt()
    .user(u -> u
            .text("Tell me the names of 5 movies whose soundtrack was composed by {composer}")
            .param("composer", "John Williams"))
    .call()
    .content();
在内部,ChatClient 使用 PromptTemplate 类来处理用户和系统文本,并基于给定的 TemplateRenderer 实现,在运行时将变量替换为提供的值。默认情况下,Spring AI 使用 StTemplateRenderer 实现,该实现基于由 Terence Parr 开发的开源 StringTemplate 引擎。
Spring AI 还提供了一个 NoOpTemplateRenderer,用于不需要模板处理的场景。
直接配置在 ChatClient 上的 TemplateRenderer(通过 .templateRenderer())仅适用于在 ChatClient 构建链中直接定义的提示词内容(例如,通过 .user()、.system())。它 不 影响 Advisors(如 QuestionAnswerAdvisor)内部使用的模板,因为这些 Advisor 拥有自己的模板定制机制(参见 Custom Advisor Templates)。
如果你希望使用不同的模板引擎,可以直接向 ChatClient 提供 TemplateRenderer 接口的自定义实现。你也可以继续使用默认的 StTemplateRenderer,但使用自定义配置。
例如,默认情况下,模板变量通过 {} 语法来识别。如果你打算在 prompt 中包含 JSON,可能需要使用不同的语法以避免与 JSON 语法冲突。例如,你可以使用 < 和 > 作为分隔符。
String answer = ChatClient.create(chatModel).prompt()
    .user(u -> u
            .text("Tell me the names of 5 movies whose soundtrack was composed by <composer>")
            .param("composer", "John Williams"))
    .templateRenderer(StTemplateRenderer.builder().startDelimiterToken('<').endDelimiterToken('>').build())
    .call()
    .content();
call() 返回值
在 ChatClient 上指定 call() 方法后,响应类型有几种不同的选项。
-
String content():返回响应的字符串内容 -
ChatResponse chatResponse():返回包含多个生成结果以及响应元数据(例如用于创建响应的 token 数量)的ChatResponse对象。 -
ChatClientResponse chatClientResponse():返回一个ChatClientResponse对象,其中包含ChatResponse对象和 ChatClient 执行上下文,从而允许你访问在顾问(advisors)执行期间使用的附加数据(例如在 RAG 流程中检索到的相关文档)。 -
entity()用于返回一个 Java 类型-
entity(ParameterizedTypeReference<T> type):用于返回实体类型的Collection。 -
entity(Class<T> type):用于返回特定的实体类型。 -
entity(StructuredOutputConverter<T> structuredOutputConverter):用于指定一个StructuredOutputConverter实例,将String转换为实体类型。 -
entity(ParameterizedTypeReference<T> type, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。 -
entity(Class<T> type, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。 -
entity(StructuredOutputConverter<T> converter, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。
-
-
responseEntity()用于同时返回ChatResponse和一个 Java 类型。当你需要在单次调用中同时访问完整的 AI 模型响应(包含元数据和生成结果)以及结构化输出实体时,这非常有用。-
responseEntity(Class<T> type):用于返回一个ResponseEntity,其中同时包含完整的ChatResponse对象和特定的实体类型。 -
responseEntity(Class<T> type, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。 -
responseEntity(ParameterizedTypeReference<T> type):用于返回一个ResponseEntity,其中同时包含完整的ChatResponse对象和实体类型的Collection。 -
responseEntity(ParameterizedTypeReference<T> type, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。 -
responseEntity(StructuredOutputConverter<T> structuredOutputConverter):用于返回一个ResponseEntity,其中同时包含完整的ChatResponse对象以及使用指定的StructuredOutputConverter转换后的实体。 -
responseEntity(StructuredOutputConverter<T> converter, Consumer<EntityParamSpec> spec):同上,带有可选的 EntityParamSpec 配置。
-
你也可以调用 stream() 方法而不是 call()。
调用 call() 方法并不会实际触发 AI 模型的执行。相反,它只是向 Spring AI 指示使用同步调用还是流式调用。实际的 AI 模型调用发生在调用 content()、chatResponse() 和 responseEntity() 等方法时。
stream() 返回值
在 ChatClient 上指定 stream() 方法后,有几种可选的响应类型:
Flux<String> content(): 返回由 AI 模型生成的字符串的Flux。Flux<ChatResponse> chatResponse(): 返回包含响应附加元数据的ChatResponse对象的Flux。Flux<ChatClientResponse> chatClientResponse(): 返回包含ChatResponse对象及 ChatClient 执行上下文的ChatClientResponse对象的Flux,从而允许你访问在 advisors 执行过程中使用的额外数据(例如,在 RAG 流程中检索到的相关文档)。
消息元数据
ChatClient 支持为用户消息和系统消息添加元数据。元数据提供了关于消息的额外上下文和信息,可被 AI 模型或下游处理使用。
向用户消息添加元数据
你可以使用 metadata() 方法为用户消息添加元数据:
// Adding individual metadata key-value pairs
String response = chatClient.prompt()
    .user(u -> u.text("What's the weather like?")
        .metadata("messageId", "msg-123")
        .metadata("userId", "user-456")
        .metadata("priority", "high"))
    .call()
    .content();

// Adding multiple metadata entries at once
Map<String, Object> userMetadata = Map.of(
    "messageId", "msg-123",
    "userId", "user-456",
    "timestamp", System.currentTimeMillis()
);

String response = chatClient.prompt()
    .user(u -> u.text("What's the weather like?")
        .metadata(userMetadata))
    .call()
    .content();
向系统消息添加元数据
类似地,你可以为系统消息添加元数据:
// Adding metadata to system messages
String response = chatClient.prompt()
    .system(s -> s.text("You are a helpful assistant.")
        .metadata("version", "1.0")
        .metadata("model", "gpt-4"))
    .user("Tell me a joke")
    .call()
    .content();
默认元数据支持
您还可以在 ChatClient 构建器级别配置默认元数据:
@Configuration
class Config {
    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder
            .defaultSystem(s -> s.text("You are a helpful assistant")
                .metadata("assistantType", "general")
                .metadata("version", "1.0"))
            .defaultUser(u -> u.text("Default user context")
                .metadata("sessionId", "default-session"))
            .build();
    }
}
元数据校验
ChatClient 会验证元数据以确保数据完整性:
-
元数据键不能为 null 或空
-
元数据值不能为 null
-
传递 Map 时,键和值都不能包含 null 元素
// This will throw an IllegalArgumentException
chatClient.prompt()
    .user(u -> u.text("Hello")
        .metadata(null, "value"))  // Invalid: null key
    .call()
    .content();

// This will also throw an IllegalArgumentException
chatClient.prompt()
    .user(u -> u.text("Hello")
        .metadata("key", null))    // Invalid: null value
    .call()
    .content();
访问元数据
元数据会被包含在生成的 UserMessage 和 SystemMessage 对象中,并可通过消息的 getMetadata() 方法访问。这在处理 advisor 中的消息或检查对话历史时尤为有用。
使用默认值
在 @Configuration 类中创建一个带有默认系统文本的 ChatClient 可以简化运行时代码。通过设置默认值,在调用 ChatClient 时仅需指定用户文本,从而无需在运行时代码路径中的每个请求中都设置系统文本。
默认系统文本
在下面的示例中,我们将配置系统文本,使其始终以海盗的语气进行回复。为了避免在运行时代码中重复编写系统文本,我们将在一个 @Configuration 类中创建一个 ChatClient 实例。
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a Pirate")
                .build();
    }

}
以及用于调用它的 @RestController:
@RestController
class AIController {

	private final ChatClient chatClient;

	AIController(ChatClient chatClient) {
		this.chatClient = chatClient;
	}

	@GetMapping("/ai/simple")
	public Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
		return Map.of("completion", this.chatClient.prompt().user(message).call().content());
	}
}
通过 curl 调用应用程序端点时,结果为:
❯ curl localhost:8080/ai/simple
{"completion":"Why did the pirate go to the comedy club? To hear some arrr-rated jokes! Arrr, matey!"}
带有参数的默认系统文本
在下面的示例中,我们将在系统文本中使用占位符,在运行时而非设计时指定补全的语音。
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a {voice}")
                .build();
    }

}
@RestController
class AIController {
	private final ChatClient chatClient;

	AIController(ChatClient chatClient) {
		this.chatClient = chatClient;
	}

	@GetMapping("/ai")
	Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message, String voice) {
		return Map.of("completion",
				this.chatClient.prompt()
						.system(sp -> sp.param("voice", voice))
						.user(message)
						.call()
						.content());
	}

}
通过 httpie 调用应用程序端点时,结果为:
http localhost:8080/ai voice=='Robert DeNiro'
{
    "completion": "You talkin' to me? Okay, here's a joke for ya: Why couldn't the bicycle stand up by itself? Because it was two tired! Classic, right?"
}
其他默认值
在 ChatClient.Builder 层级,你可以指定默认的提示配置。
-
defaultOptions(ChatOptions chatOptions): 传入在ChatOptions类中定义的通用选项,或如OpenAiChatOptions中那样的模型特定选项。有关模型特定ChatOptions实现的更多信息,请参阅 JavaDocs。 -
defaultTools(Object… tools): 注册一个或多个对每个请求都可用的默认工具。接受ToolCallback、ToolCallbackProvider或带有@Tool注解方法的 POJO 的混合组合。 -
defaultToolContext(Map<String, Object> toolContext): 为工具执行设置默认上下文。 -
defaultSystem(String text),defaultSystem(Resource text),defaultSystem(Consumer<PromptSystemSpec> systemSpecConsumer): 这些方法允许你定义默认的系统文本。 -
defaultUser(String text),defaultUser(Resource text),defaultUser(Consumer<UserSpec> userSpecConsumer): 这些方法允许你定义用户文本。Consumer<UserSpec>允许你使用 Lambda 来指定用户文本以及任何默认参数。 -
defaultTemplateRenderer(TemplateRenderer templateRenderer): 为提示词模板设置默认的TemplateRenderer。 -
defaultAdvisors(Advisor… advisor),defaultAdvisors(List<Advisor> advisors): Advisors(顾问)允许修改用于创建Prompt的数据。QuestionAnswerAdvisor实现支持Retrieval Augmented Generation(检索增强生成)模式,通过向提示词追加与用户文本相关的上下文信息来实现。 -
defaultAdvisors(Consumer<AdvisorSpec> advisorSpecConsumer): 此方法允许你定义一个Consumer,使用AdvisorSpec配置多个 Advisors(顾问)。Advisors(顾问)可以修改用于创建最终Prompt的数据。Consumer<AdvisorSpec>让你可以指定一个 Lambda 来添加 Advisors(顾问),例如QuestionAnswerAdvisor,它通过在提示词中追加基于用户文本的相关上下文信息来支持Retrieval Augmented Generation(检索增强生成)。
你可以在运行时使用去掉 default 前缀的对应方法来覆盖这些默认值。
-
options(ChatOptions.Builder optionsCustomizer) -
tools(Object… tools) -
toolContext(Map<String, Object> toolContext) -
messages(Message… messages),messages(List<Message> messages) -
system(String text),system(Resource text),system(Consumer<PromptSystemSpec> systemSpecConsumer) -
user(String text),user(Resource text),user(Consumer<UserSpec> userSpecConsumer) -
templateRenderer(TemplateRenderer templateRenderer) -
advisors(Advisor… advisor),advisors(List<Advisor> advisors) -
advisors(Consumer<AdvisorSpec> advisorSpecConsumer)
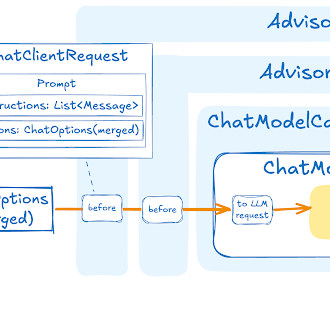
修改 ChatClient
您可以使用 mutate() 方法基于现有的 ChatClient(或 ChatClientRequestSpec)的配置创建一个新的 ChatClient(或 ChatClientRequestSpec):
-
在
ChatClient上:Builder mutate()返回一个使用客户端默认设置初始化的ChatClient.Builder。 -
在
ChatClientRequestSpec上:Builder mutate()返回一个使用请求当前设置初始化的ChatClient.Builder。
这在创建派生客户端或请求而无需重新定义所有选项时非常有用。
顾问
Advisors API 提供了一种灵活且强大的方式,用于拦截、修改和增强 Spring 应用程序中 AI 驱动的交互。
调用 AI 模型时,一种常见的模式是将上下文数据附加到提示词中,或对其内容进行增强。
此类上下文数据可以具有不同的类型。常见类型包括:
-
您自己的数据:这是 AI 模型未曾训练过的数据。即使模型见过类似的数据,在生成响应时,附加的上下文数据也会优先被考虑。
-
对话历史:聊天模型的 API 是无状态的。如果您告诉 AI 模型您的名字,它在后续交互中不会记住。每次请求时必须发送对话历史,以确保在生成响应时考虑之前的交互内容。
在 ChatClient 中配置 Advisor
ChatClient 流式 API 提供了一个 AdvisorSpec 接口用于配置 advisors。该接口提供了添加参数、一次性设置多个参数,以及向链中添加一个或多个 advisors 的方法。
interface AdvisorSpec {
    AdvisorSpec param(String k, Object v);
    AdvisorSpec params(Map<String, Object> p);
    AdvisorSpec advisors(Advisor... advisors);
    AdvisorSpec advisors(List<Advisor> advisors);
}
顾问添加到链中的顺序至关重要,因为它决定了它们的执行顺序。每个顾问都会以某种方式修改提示词或上下文,并且一个顾问所做的修改会传递给链中的下一个顾问。
ChatClient.builder(chatModel)
    .build()
    .prompt()
    .advisors(a -> a
        .advisors(
            MessageChatMemoryAdvisor.builder(chatMemory).build(),
            QuestionAnswerAdvisor.builder(vectorStore).build()
        )
        .param(ChatMemory.CONVERSATION_ID, conversationId))
    .user(userText)
    .call()
    .content();
在此配置中,MessageChatMemoryAdvisor 将首先执行,将对话历史添加到提示词中。随后,QuestionAnswerAdvisor 将基于用户的问题以及添加的对话历史执行搜索,从而可能提供更为相关 的结果。
每次使用记忆顾问(memory advisor)的调用中,都必须通过 .param() 提供 ChatMemory.CONVERSATION_ID。省略它将在运行时抛出 IllegalArgumentException。
检索增强生成
请参阅 Retrieval Augmented Generation 指南。
日志记录
SimpleLoggerAdvisor 是一种顾问(Advisor),用于记录 ChatClient 的 request 和 response 数据。这对于调试和监控您的 AI 交互非常有用。
Spring AI 支持针对 LLM 和向量存储交互的可观测性。更多信息请参考 Observability 指南。
要启用日志记录,在创建 ChatClient 时将 SimpleLoggerAdvisor 添加到顾问链中。建议将其添加在链的末尾:
ChatResponse response = ChatClient.create(chatModel).prompt()
        .advisors(new SimpleLoggerAdvisor())
        .user("Tell me a joke?")
        .call()
        .chatResponse();
要查看日志,请将 advisor 包的日志级别设置为 DEBUG:
logging.level.org.springframework.ai.chat.client.advisor=DEBUG
请将其添加到你的 application.properties 或 application.yaml 文件中。
你可以使用以下构造函数来自制记录 AdvisedRequest 和 ChatResponse 中的哪些数据:
SimpleLoggerAdvisor(
    Function<ChatClientRequest, String> requestToString,
    Function<ChatResponse, String> responseToString,
    int order
)
示例用法:
SimpleLoggerAdvisor customLogger = new SimpleLoggerAdvisor(
    request -> "Custom request: " + request.prompt().getUserMessage(),
    response -> "Custom response: " + response.getResult(),
    0
);
这允许您根据具体需求定制记录的信息。
在生产环境中记录敏感信息时要谨慎。
工具调用
ChatClient 始终会在顾问链中自动注册一个 ToolCallingAdvisor,除非显式禁用了自动注册(详见下文)。这确保了由其他顾问在运行时动态注入的工具能够被正确处理,即使该调用中未配置任何静态工具也是如此。
String response = ChatClient.builder(chatModel)
    .build()
    .prompt("What day is tomorrow?")
    .tools(new DateTimeTools())   // ToolCallingAdvisor is auto-registered
    .call()
    .content();
ToolCallingAdvisor 默认注册于 Ordered.HIGHEST_PRECEDENCE + 300。
禁用自动注册
全局(所有调用)
设置 spring.ai.chat.client.tool-calling.enabled=false 以禁用由自动配置的 ChatClient 发出的每次调用的自动注册:
spring.ai.chat.client.tool-calling.enabled=false
当设置此属性时,工具仍会以定义的形式发送给 AI 模型,但响应中的工具调用不会自动执行。请使用 用户控制工具执行 来自行驱动该循环。
每次调用
你可以使用 AdvisorParams.toolCallingAdvisorAutoRegister(false) 来禁用单次调用的自动注册:
chatClient.prompt("What day is tomorrow?")
    .tools(new DateTimeTools())
    .advisors(AdvisorParams.toolCallingAdvisorAutoRegister(false))
    .call()
    .content();
或者,您也可以提供自己的 ToolCallingAdvisor(或任何其他实现了 ToolAdvisor 的顾问)——在这种情况下,由于链中已经包含了一个 ToolAdvisor,自动注册会被自动抑制。
你可以通过 .advisors() 传入自定义的顾问:
chatClient.prompt("What day is tomorrow?")
    .tools(new DateTimeTools())
    .advisors(customAdvisor)    // auto-registration suppressed
    .call()
    .content();
自定义默认的 ToolCallingAdvisor
spring.ai.chat.client.tool-calling.* 属性用于控制自动配置的 ToolCallingAdvisor:
| 属性 | 默认值 | 描述 |
|---|---|---|
spring.ai.chat.client.tool-calling.enabled | true | 设置为 false 可禁用所有调用的 ToolCallingAdvisor 自动注册。工具仍会发送给模型,但工具调用不会自动执行。 |
spring.ai.chat.client.tool-calling.advisor-order | Ordered.HIGHEST_PRECEDENCE + 300 | 自动注册的 ToolCallingAdvisor 在 advisor 链中的位置。 |
Spring Boot: advisor 顺序属性
通过 spring.ai.chat.client.tool-calling.advisor-order 属性,可以最简单地对自动注册的 advisor 进行调优。该属性控制 ToolCallingAdvisor 在 advisor 链中的插入位置:
spring.ai.chat.client.tool-calling.advisor-order=0
该值必须低于任何需要在工具调用循环内部运行的 advisor 的 order(即在每次迭代时重复执行),并且高于任何需要在循环外部运行的 advisor(即每个用户请求仅执行一次)。默认值为 ToolCallingAdvisor.DEFAULT_ORDER。
Spring Boot:用户可控工具执行
要观察工具调用循环的每次迭代(例如,将中间块转发到 UI),请使用 AdvisorParams.toolCallingAdvisorAutoRegister(false) 禁用每次调用时自动注册的 Advisor,并自行驱动该循环。完整的示例请参见 用户控制工具执行 — 使用 ChatClient。
Spring Boot: 自定义 ToolCallingAdvisor.Builder Bean
要实现更深入的自定义——例如提供自定义的 ToolCallingManager——请声明一个 ToolCallingAdvisor.Builder<?> Bean。Spring Boot 自动配置 Bean 上的 @ConditionalOnMissingBean 注解意味着您的 Bean 会优先生效:
@Bean
ToolCallingAdvisor.Builder<?> toolCallingAdvisorBuilder(ToolCallingManager myToolCallingManager) {
    return ToolCallingAdvisor.builder()
        .toolCallingManager(myToolCallingManager)
        .advisorOrder(Ordered.LOWEST_PRECEDENCE);
}
然后,ChatClient.Builder Bean 会自动与这个自定义构建器进行装配。
无 Spring Boot
在不使用 Spring Boot 自动配置时,请将预先配置好的 ToolCallingAdvisor.Builder 直接传递给 ChatClient.builder():
ToolCallingManager customManager = ToolCallingManager.builder()
    // custom resolver, exception processor, etc.
    .build();

ChatClient chatClient = ChatClient
    .builder(chatModel, observationRegistry, null, null,
            ToolCallingAdvisor.builder().toolCallingManager(customManager))
    .build();

// Every prompt that registers tools will use customManager in the auto-registered advisor
chatClient.prompt("What day is tomorrow?")
    .tools(new DateTimeTools())
    .call()
    .content();
ToolAdvisor 标记接口
ToolAdvisor 是一个标记接口,用于向 ChatClient 表明顾问链已经处理了工具的执行。在自定义顾问中实现该接口可以防止自动注册第二个 ToolCallingAdvisor。
有关更多详情,请参阅 扩展循环:自定义 ToolAdvisor。
聊天记忆
接口 ChatMemory 表示聊天会话记忆的存储。它提供了向会话中添加消息、从会话中检索消息以及清除会话历史的方法。
目前内置的实现为:MessageWindowChatMemory。
MessageWindowChatMemory 是一种聊天记忆实现,它维护一个消息窗口,窗口大小上限为指定值(默认:20 条消息)。当消息数量超过该限制时,较早的消息会被移除,但系统消息会保留。如果添加了新的系统消息,所有之前的系统消息将从内存中移除。这确保了对话中始终可以获取最新的上下文,同时保持内存使用有界。
MessageWindowChatMemory 由 ChatMemoryRepository 抽象提供支持,该抽象为对话聊天记忆提供了存储实现。目前有多种可用的实现,包括 InMemoryChatMemoryRepository、JdbcChatMemoryRepository、CassandraChatMemoryRepository、Neo4jChatMemoryRepository、MongoChatMemoryRepository 和 RedisChatMemoryRepository。
ChatMemory.CONVERSATION_ID 参数对于所有 memory advisors 均为必填项。在每次调用时都必须通过 .advisors(a → a.param(ChatMemory.CONVERSATION_ID, conversationId)) 提供。如果省略该参数,将抛出 IllegalArgumentException。不存在默认的对话 ID。
更多详细信息和使用示例,请参阅Chat Memory 文档。
MemoryAdvisor 标记接口
MemoryAdvisor 是 BaseChatMemoryAdvisor 所扩展的一个标记接口。DefaultChatClient 在自动注册逻辑中使用该标记来检测下游的内存 Advisor。
未继承 BaseChatMemoryAdvisor 但应参与此检测的自定义内存建议器,应实现 MemoryAdvisor。
实现说明
在 ChatClient 中结合使用命令式(imperative)和响应式(reactive)编程模型是该 API 的一个独特特性。通常,应用程序要么是响应式的,要么是命令式的,而不会同时兼具两者。
-
当定制 Model 实现中 HTTP 客户端的交互时,必须同时配置 RestClient 和 WebClient。
-
流式处理仅支持通过 Reactive 技术栈实现。出于此原因,命令式应用必须包含 Reactive 技术栈(例如 spring-boot-starter-webflux)。
-
非流式处理仅支持通过 Servlet 技术栈实现。出于此原因,响应式应用必须包含 Servlet 技术栈(例如 spring-boot-starter-web),并预期某些调用会是阻塞式的。
-
工具调用(Tool calling)是命令式的,会导致阻塞式的工作流。这还会导致部分被中断的 Micrometer 观测(Observations)(例如,ChatClient span 和工具调用 span 没有关联,前一个 span 因此保持未完成状态)。
-
内置的 advisors 对标准调用执行阻塞操作,对流式调用执行非阻塞操作。用于 advisor 流式调用的 Reactor Scheduler 可以通过每个 Advisor 类上的 Builder 进行配置。
章节总结
Advisors
1 个项目