NVIDIA Chat
NVIDIA LLM API 是一个代理式 AI 推理引擎,提供来自各个供应商的多种模型。
Spring AI 通过复用现有的 OpenAI 客户端与 NVIDIA LLM API 集成。为此,你需要将 base-url 设置为 https://integrate.api.nvidia.com,选择其中一个提供的 LLM models(LLM 模型),并获取对应的 api-key。

NVIDIA LLM API 要求显式设置 max-tokens 参数,否则将抛出服务器错误。
检查 NvidiaWithOpenAiChatModelIT.java 测试文件,以查看使用 NVIDIA LLM API 结合 Spring AI 的示例。
前置条件
-
创建 NVIDIA 账户并确保具有足够的额度。
-
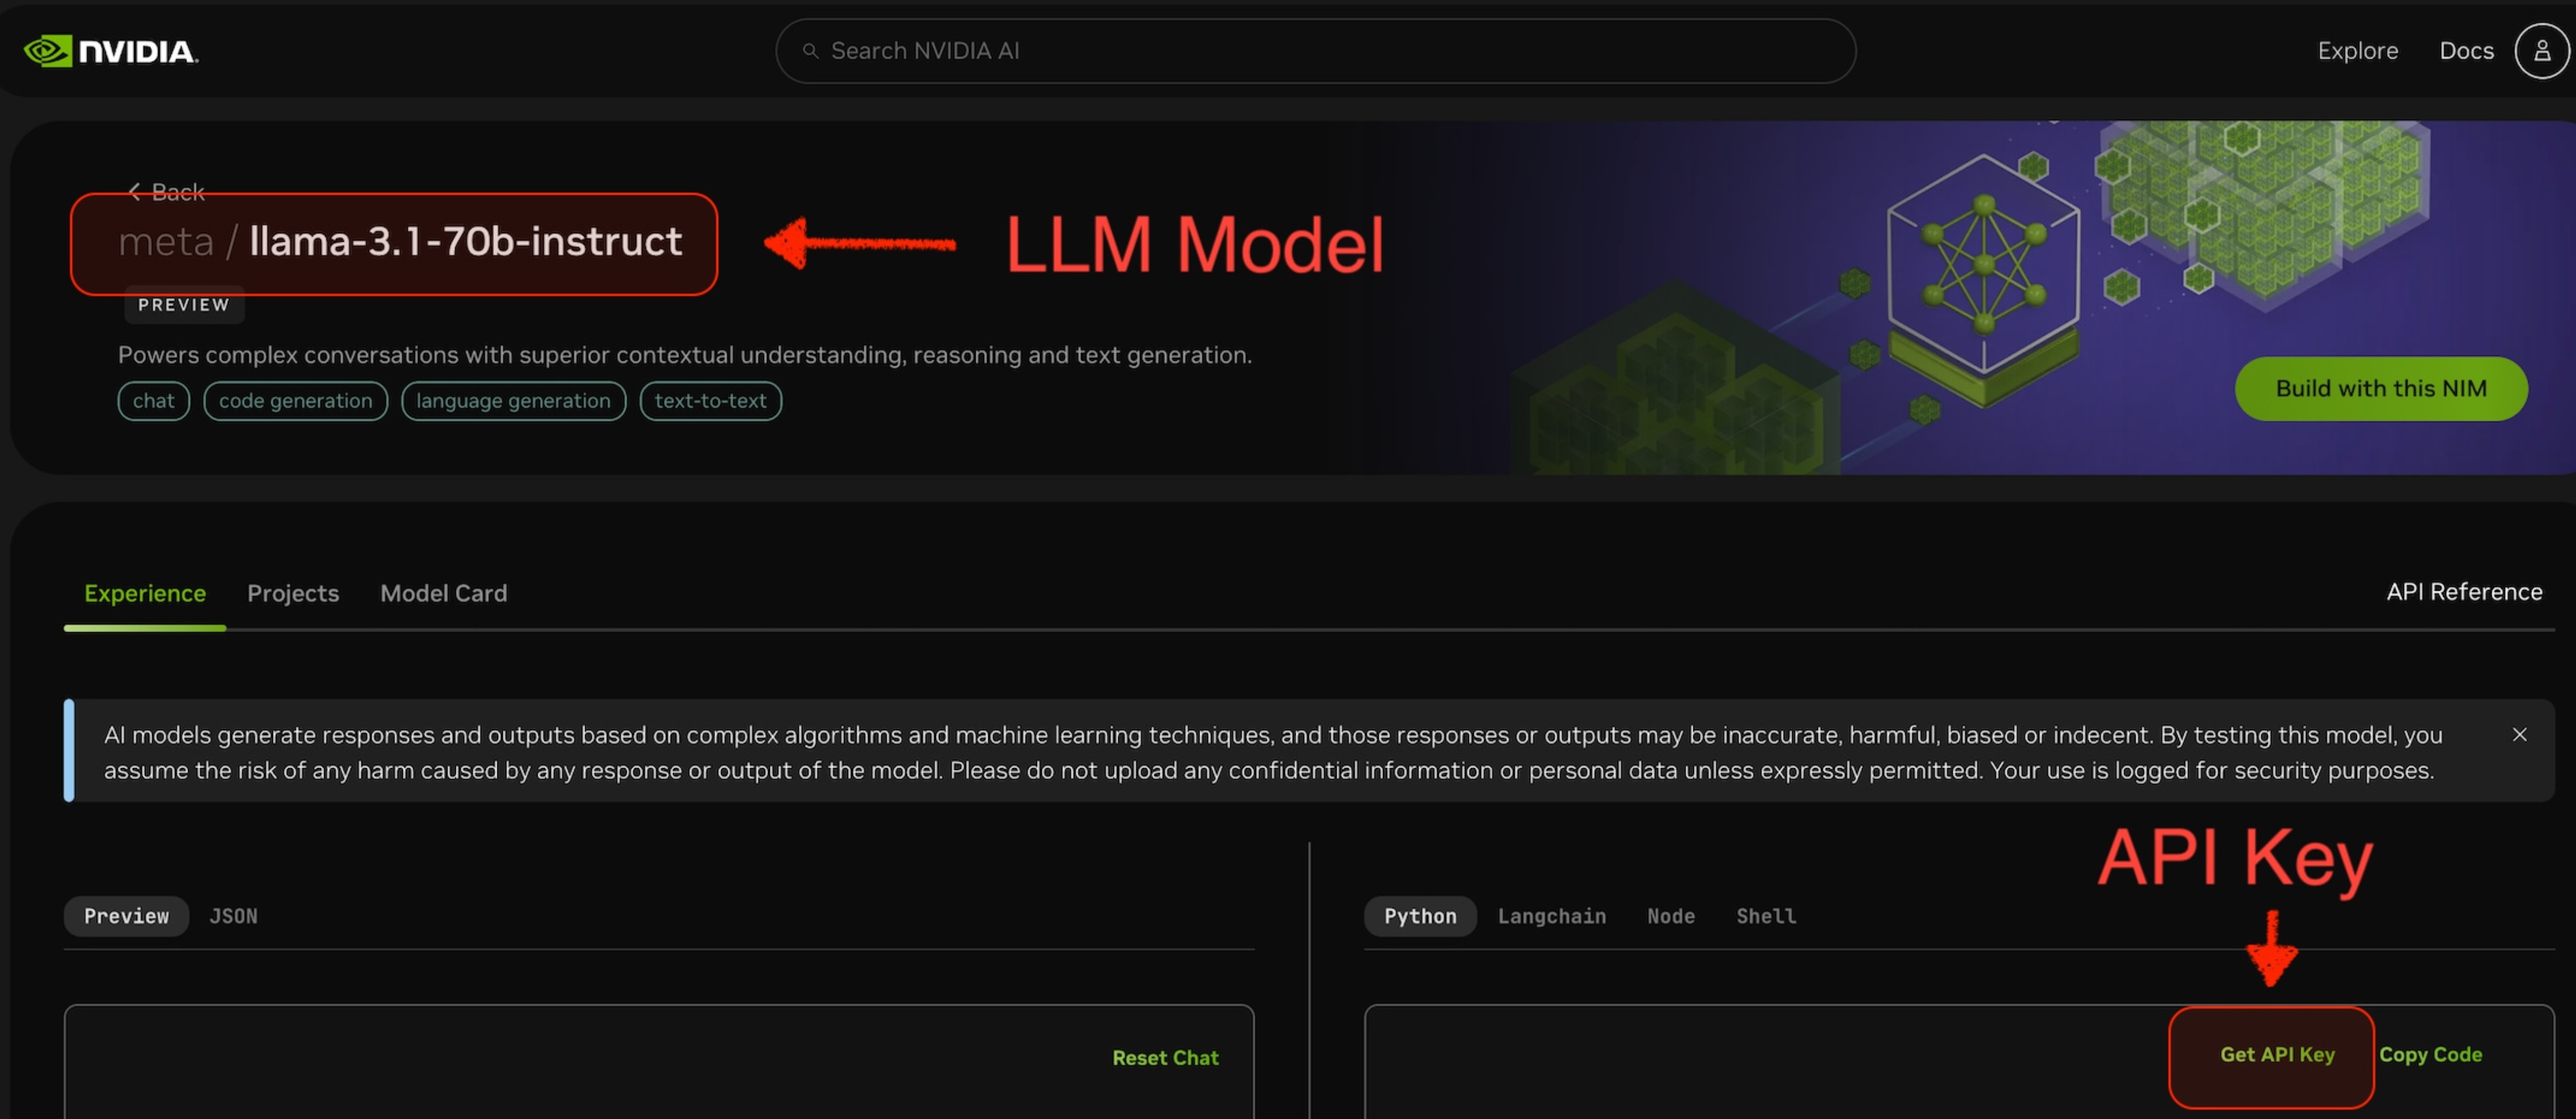
选择要使用的 LLM 模型。例如,在下方截图中使用的是
meta/llama-3.1-70b-instruct。 -
从所选模型的页面中,您可以获取用于访问该模型的
api-key。
自动配置
Spring AI 自动配置和 starter 模块的 artifact 名称发生了重大变更。更多信息请参阅升级说明。
Spring AI 为 OpenAI Chat Client 提供了 Spring Boot 自动配置。若要启用它,请将以下依赖项添加到项目的 Maven pom.xml 文件中:
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-openai</artifactId>
</dependency>
或添加到你的 Gradle build.gradle 构建文件中。
dependencies {
    implementation 'org.springframework.ai:spring-ai-starter-model-openai'
}
参考依赖管理 部分,将 Spring AI BOM 添加到您的构建文件中。
聊天属性
重试属性
前缀 spring.ai.retry 用作属性前缀,用于配置 OpenAI 聊天模型的重试机制。
| Property | Description | Default |
|---|---|---|
| spring.ai.retry.max-attempts | 最大重试次数。 | 10 |
| spring.ai.retry.backoff.initial-interval | 指数退避策略的初始睡眠时长。 | 2 sec. |
| spring.ai.retry.backoff.multiplier | 退避间隔倍数。 | 5 |
| spring.ai.retry.backoff.max-interval | 最大退避时长。 | 3 min. |
| spring.ai.retry.on-client-errors | 如果为 false,抛出 NonTransientAiException,并且不对 4xx 客户端错误代码进行重试。 | false |
| spring.ai.retry.exclude-on-http-codes | 不应触发重试的 HTTP 状态码列表(例如:用于抛出 NonTransientAiException)。 | empty |
| spring.ai.retry.on-http-codes | 应触发重试的 HTTP 状态码列表(例如:用于抛出 TransientAiException)。 | empty |
连接属性
前缀 spring.ai.openai 用作属性前缀,用于连接 OpenAI。
| Property | Description | Default |
|---|---|---|
| spring.ai.openai.base-url | 连接的 URL。必须设置为 https://integrate.api.nvidia.com | - |
| spring.ai.openai.api-key | NVIDIA API 密钥 | - |
配置属性
聊天自动配置的启用与禁用,现改为通过带有前缀 spring.ai.model.chat 的顶级属性进行配置。
启用时,设置 spring.ai.model.chat=openai(默认即为启用状态)
禁用时,设置 spring.ai.model.chat=none(或任何不等于 openai 的值)
此变更旨在支持多模型配置。
前缀 spring.ai.openai.chat 是用于配置 OpenAI 聊天模型实现的属性前缀。
| 属性 | 描述 | 默认 |
|---|---|---|
| spring.ai.openai.chat.enabled(已移除,不再有效) | 启用 OpenAI 聊天模型。 | true |
| spring.ai.model.chat | 启用 OpenAI 聊天模型。 | OpenAI |
| spring.ai.openai.chat.base-url | 可选的 spring.ai.openai.base-url 覆盖属性,用于提供专用于聊天的 URL。必须设置为 https://integrate.api.nvidia.com | - |
| spring.ai.openai.chat.api-key | Optional 覆盖 spring.ai.openai.api-key,以提供专用于 Chat 的 api-key | - |
| spring.ai.openai.chat.model | 要使用的 NVIDIA LLM 模型 | - |
| spring.ai.openai.chat.temperature | 用于控制生成补全结果表现出的创造性程度的采样温度(sampling temperature)。较高的值会使输出更具随机性,而较低的值则会使结果更集中且更具确定性。不建议在同一次补全请求中同时修改 temperature 和 top_p,因为这两项设置的交互作用难以预测。 | 0.8 |
| spring.ai.openai.chat.frequency-penalty | 取值范围为 -2.0 至 2.0 之间的数值。正值会根据新 token 在已有文本中的出现频率进行惩罚,从而降低模型逐字重复相同语句的可能性。 | 0.0f |
| spring.ai.openai.chat.max-tokens | 生成聊天补全时生成的令牌(token)最大数量。输入令牌与生成令牌的总长度受模型上下文长度限制。 | 注意:NVIDIA LLM API 要求显式设置 max-tokens 参数,否则将抛出服务器错误。 |
| spring.ai.openai.chat.n | 为每条输入消息生成多少个聊天补全选项。请注意,费用将基于所有选项生成的 token 总数计算。为降低成本,请将 n 设置为 1。 | 1 |
| spring.ai.openai.chat.presence-penalty | 取值范围在 -2.0 到 2.0 之间的数值。正值会根据新 token 是否已经出现在当前文本中来对其施加惩罚,从而增加模型谈论新话题的可能性。 | - |
| spring.ai.openai.chat.response-format | 一个指定模型输出格式的对象。设置为 { "type": "json_object" } 可启用 JSON 模式,该模式保证模型生成的消息是有效的 JSON。 | - |
| spring.ai.openai.chat.seed | 此功能处于 Beta 版本。如果指定该参数,我们的系统将尽最大努力进行确定性采样,从而确保具有相同 seed 和参数的重复请求返回相同的结果。 | - |
| spring.ai.openai.chat.stop | 最多 4 个序列,API 将停止生成更多的 token。 | - |
| spring.ai.openai.chat.top-p | 作为对基于温度采样的替代方案,核采样(nucleus sampling)让模型仅考虑具有 top_p 概率质量的 token 结果。例如,0.1 表示仅考虑构成前 10% 概率质量的 token。我们通常建议修改此参数或 temperature 参数,但不要同时修改两者。 | - |
| spring.ai.openai.chat.tools | 模型可调用的工具列表。目前,仅支持将函数作为工具。使用此参数提供模型可以生成 JSON 输入的函数列表。 | - |
| spring.ai.openai.chat.tool-choice | 控制模型调用哪个函数(如果有的话)。none 表示模型不调用函数,而是生成消息。auto 表示模型可以在生成消息或调用函数之间进行选择。通过指定特定函数,例如 {"type: "function", "function": {"name": "my_function"}},可以强制模型调用该函数。在没有函数存在的情况下,默认为 none;在存在函数的情况下,默认为 auto。 | - |
| spring.ai.openai.chat.user | 用于代表您的最终用户的唯一标识符,可帮助 OpenAI 监控并检测滥用行为。 | - |
| spring.ai.openai.chat.stream-usage | (仅限流式传输)设置后,将在请求结束时额外返回一个包含整个请求 token 使用统计信息的 chunk。该 chunk 中的 choices 字段为空数组,且所有其他 chunk 也会包含一个 usage 字段,但其值为 null。 | false |
| spring.ai.openai.chat.tool-callbacks | 要注册到 ChatModel 的 Tool Callbacks。 | - |
所有以 spring.ai.openai.chat 为前缀的属性,都可以在运行时通过向 Prompt 调用添加请求特定的 Runtime Options 来覆盖。
运行时选项
OpenAiChatOptions.java 提供模型配置,例如要使用的模型、temperature、frequency penalty 等。
启动时,默认选项可通过 OpenAiChatModel(api, options) 构造函数或 spring.ai.openai.chat.* 属性进行配置。
在运行时,您可以通过在 Prompt 调用中添加新的、特定于请求的选项来覆盖默认选项。例如,要为特定请求覆盖默认的模型和温度:
ChatResponse response = chatModel.call(
    new Prompt(
        "Generate the names of 5 famous pirates.",
        OpenAiChatOptions.builder()
            .model("mixtral-8x7b-32768")
            .temperature(0.4)
        .build()
    ));
除了模型特定的 OpenAiChatOptions 之外,您还可以使用通过 ChatOptions#builder() 创建的便携式 ChatOptions 实例。
工具调用
NVIDIA LLM API 支持工具调用,前提是所选模型支持该功能。Spring AI 负责处理工具执行循环。
对于大多数应用,请搭配自动注册的 ToolCallingAdvisor 使用 ChatClient —— 参见 工具调用。如需自行控制循环的低级操作,请参见 ChatModel 工具调用。
示例控制器
创建 一个新的 Spring Boot 项目,并将 spring-ai-starter-model-openai 添加到您的 pom(或 gradle)依赖项中。
在 src/main/resources 目录下添加一个 application.properties 文件,以启用并配置 OpenAi 聊天模型:
spring.ai.openai.api-key=${NVIDIA_API_KEY}
spring.ai.openai.base-url=https://integrate.api.nvidia.com
spring.ai.openai.chat.model=meta/llama-3.1-70b-instruct

# The NVIDIA LLM API doesn't support embeddings, so we need to disable it.
spring.ai.model.embedding=none

# The NVIDIA LLM API requires this parameter to be set explicitly or server internal error will be thrown.
spring.ai.openai.chat.max-tokens=2048
将 api-key 替换为您的 NVIDIA 凭证。
NVIDIA LLM API 要求显式设置 max-token 参数,否则会抛出服务器错误。
以下是一个简单的 @Controller 类的示例,该类使用聊天模型进行文本生成。
@RestController
public class ChatController {

    private final OpenAiChatModel chatModel;

    @Autowired
    public ChatController(OpenAiChatModel chatModel) {
        this.chatModel = chatModel;
    }

    @GetMapping("/ai/generate")
    public Map generate(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
        return Map.of("generation", this.chatModel.call(message));
    }

    @GetMapping("/ai/generateStream")
	public Flux<ChatResponse> generateStream(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
        Prompt prompt = new Prompt(new UserMessage(message));
        return this.chatModel.stream(prompt);
    }
}