Bedrock Converse API
Amazon Bedrock Converse API 为对话式 AI 模型提供统一接口,并具备增强的功能,包括函数/工具调用、多模态输入以及流式响应。
Bedrock Converse API 具有以下高级功能:
-
工具/函数调用:支持在对话中进行函数定义和工具使用
-
多模态输入:支持在对话中处理文本和图像输入
-
流式支持:实时流式传输模型响应
-
系统消息:支持系统级指令和上下文设置
Bedrock Converse API 提供了跨多个模型提供商的统一接口,同时处理 AWS 特定的认证和基础设施问题。目前,Converse API 支持的模型 包括:Amazon Titan、Amazon Nova、AI21 Labs、Anthropic Claude、Cohere Command、Meta Llama、Mistral AI。
遵循 Bedrock 的建议,Spring AI 正在过渡到使用 Amazon Bedrock 的 Converse API 来实现所有聊天对话功能。尽管现有的 InvokeModel API 支持对话应用程序,但我们强烈建议在所有 Chat 对话模型中采用 Converse API。
Converse API 不支持 embedding 操作,因此这些功能将保留在当前 API 中,现有 InvokeModel API 中的 embedding 模型功能也将得以维持。
先决条件
有关设置 API 访问权限,请参阅 Getting started with Amazon Bedrock
-
获取 AWS 凭证:如果您还没有 AWS 账号且尚未配置 AWS CLI,此视频教程可以帮助您完成配置:AWS CLI & SDK Setup in Less Than 4 Minutes!。您应该能够获取您的访问密钥和安全密钥。
-
启用要使用的模型:前往 Amazon Bedrock,从左侧的 Model Access 菜单中,配置对您将要使用的模型的访问权限。
自动配置
Spring AI 的自动配置和 starter 模块的构件名称(artifact names)已发生显著变更。更多信息请参阅 升级说明。
在项目的 Maven pom.xml 或 Gradle build.gradle 构建文件中添加 spring-ai-starter-model-bedrock-converse 依赖项:
- Maven
- Gradle
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-bedrock-converse</artifactId>
</dependency>
dependencies {
    implementation 'org.springframework.ai:spring-ai-starter-model-bedrock-converse'
}
参考 依赖管理 章节,将 Spring AI BOM 添加到您的构建文件中。
聊天属性
前缀 spring.ai.bedrock.aws 是用于配置与 AWS Bedrock 连接的属性前缀。
| 属性 | 描述 | 默认值 |
|---|---|---|
| spring.ai.bedrock.aws.region | 使用的 AWS 区域 | us-east-1 |
| spring.ai.bedrock.aws.timeout | 整个 API 调用的最大持续时间 | 5m |
| spring.ai.bedrock.aws.connection-timeout | 建立连接时的最大等待时间 | 5s |
| spring.ai.bedrock.aws.connection-acquisition-timeout | 从连接池获取新连接的最大等待时间 | 30s |
| spring.ai.bedrock.aws.async-read-timeout | 读取异步响应的最大持续时间 | 30s |
| spring.ai.bedrock.aws.access-key | AWS 访问密钥 | - |
| spring.ai.bedrock.aws.secret-key | AWS 秘密密钥 | - |
| spring.ai.bedrock.aws.session-token | 用于临时凭据的 AWS 会话令牌 | - |
| spring.ai.bedrock.aws.profile.name | AWS 配置文件名称。 | - |
| spring.ai.bedrock.aws.profile.credentials-path | AWS 凭据文件路径。 | - |
| spring.ai.bedrock.aws.profile.configuration-path | AWS 配置文件路径。 | - |
聊天自动配置(chat auto-configurations)的启用和禁用现已通过前缀为 spring.ai.model.chat 的顶层属性进行配置。
要启用,设置 spring.ai.model.chat=bedrock-converse(默认情况下已启用)。
要禁用,设置 spring.ai.model.chat=none(或任何与 bedrock-converse 不匹配的值)。
此更改旨在允许配置多个模型。
前缀 spring.ai.bedrock.converse.chat 是用于配置 Converse API 聊天模型实现的属性前缀。
| 属性 | 描述 | 默认值 |
|---|---|---|
| spring.ai.bedrock.converse.chat.enabled (已移除且不再有效) | 启用 Bedrock Converse 聊天模型。 | true |
| spring.ai.model.chat | 启用 Bedrock Converse 聊天模型。 | bedrock-converse |
| spring.ai.bedrock.converse.chat.model | 要使用的模型 ID。您可以使用 受支持的模型和模型功能 | None。请从 AWS Bedrock 控制台中选择您的 modelId。 |
| spring.ai.bedrock.converse.chat.temperature | 控制输出的随机性。取值范围为 [0.0, 1.0] | 0.8 |
| spring.ai.bedrock.converse.chat.top-p | 采样时考虑的最大累计 token 概率。 | AWS Bedrock 默认值 |
| spring.ai.bedrock.converse.chat.top-k | 生成下一个 token 时的 token 选择数量。 | AWS Bedrock 默认值 |
| spring.ai.bedrock.converse.chat.max-tokens | 生成响应中的最大 token 数量。 | 500 |
运行时选项
使用便携式 ChatOptions 或 BedrockChatOptions 便携式构建器来创建模型配置,例如 temperature、maxToken、topP 等。
启动时,可以通过 BedrockConverseProxyChatModel(api, options) 构造函数或 spring.ai.bedrock.converse.chat.* 属性来配置默认选项。
在运行时,你可以通过向 Prompt 调用中添加新的、特定于请求的选项来覆盖默认选项:
var options = BedrockChatOptions.builder()
        .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
        .temperature(0.6)
        .maxTokens(300)
        .toolCallbacks(List.of(FunctionToolCallback.builder("getCurrentWeather", new WeatherService())
            .description("Get the weather in location. Return temperature in 36°F or 36°C format. Use multi-turn if needed.")
            .inputType(WeatherService.Request.class)
            .build()))
        .build();

String response = ChatClient.create(this.chatModel)
    .prompt("What is current weather in Amsterdam?")
    .options(options)
    .call()
    .content();
提示缓存
AWS Bedrock 的 提示缓存功能 允许你缓存常用提示,以降低重复交互的成本并提升响应速度。缓存提示后,后续相同的请求可复用已缓存的内容,从而显著减少需要处理的输入 token 数量。
支持的模型
通过 AWS Bedrock 提供的 Claude 3.x、Claude 4.x 以及 Amazon Nova 模型均支持提示词缓存(Prompt caching)。
Token 要求
不同模型对缓存生效所需的最低 Token 阈值有所不同:
- Claude Sonnet 4 及大多数模型:1024 个及以上 Token
- 具体模型的要求可能有所不同,请参阅 AWS Bedrock 文档
缓存策略
Spring AI 通过 BedrockCacheStrategy 枚举提供策略缓存放置功能:
-
NONE:完全禁用提示缓存(默认值) -
SYSTEM_ONLY:仅缓存系统消息内容 -
TOOLS_ONLY:仅缓存工具定义(仅限 Claude 模型) -
SYSTEM_AND_TOOLS:同时缓存系统消息和工具定义(仅限 Claude 模型) -
CONVERSATION_HISTORY:在聊天记忆场景中缓存整个对话历史
这一策略性方法确保了最优的缓存断点放置位置,同时保持在 AWS Bedrock 的 4 个断点限制之内。
Amazon Nova 限制
Amazon Nova 模型(Nova Micro、Lite、Pro、Premier)仅支持对 system 和 messages 内容进行缓存。它们不支持对 tools 进行缓存。
如果尝试在 Nova 模型上使用 TOOLS_ONLY 或 SYSTEM_AND_TOOLS 策略,AWS 将返回 ValidationException。对于 Amazon Nova 模型,请使用 SYSTEM_ONLY 策略。
启用提示词缓存
通过在 BedrockChatOptions 中设置 cacheOptions 并选择一种 strategy 来启用提示缓存。
仅限系统的缓存
最常见的用例——在多个请求之间缓存系统指令:
// Cache system message content
ChatResponse response = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage("You are a helpful AI assistant with extensive knowledge..."),
            new UserMessage("What is machine learning?")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                .build())
            .maxTokens(500)
            .build()
    )
);
仅工具缓存
在保持系统提示词动态的同时,缓存大型工具定义(仅适用于 Claude 模型):
// Cache tool definitions only
ChatResponse response = chatModel.call(
    new Prompt(
        "What's the weather in San Francisco?",
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.TOOLS_ONLY)
                .build())
            .toolCallbacks(weatherToolCallbacks)  // Large tool definitions
            .maxTokens(500)
            .build()
    )
);
该策略仅支持 Claude 模型。Amazon Nova 模型将返回 ValidationException。
系统与工具缓存
为系统指令和工具定义建立缓存以最大化复用(仅限 Claude 模型):
// Cache system message and tool definitions
ChatResponse response = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage("You are a weather analysis assistant..."),
            new UserMessage("What's the weather like in Tokyo?")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_AND_TOOLS)
                .build())
            .toolCallbacks(weatherToolCallbacks)
            .maxTokens(500)
            .build()
    )
);
此策略使用 2 个缓存断点(一个用于工具,一个用于系统)。仅在 Claude 模型上受支持。
对话历史缓存
为多轮对话聊天机器人和助手缓存不断增长的对话历史:
// Cache conversation history with ChatClient and memory
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultSystem("You are a personalized career counselor...")
    .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
    .build();

String response = chatClient.prompt()
    .user("What career advice would you give me?")
    .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
    .options(BedrockChatOptions.builder()
        .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
        .cacheOptions(BedrockCacheOptions.builder()
            .strategy(BedrockCacheStrategy.CONVERSATION_HISTORY)
            .build())
        .maxTokens(500)
        .build())
    .call()
    .content();
多块系统消息缓存
使用 advisors(例如,RAG 上下文注入)时,您的系统提示可能由多个 SystemMessage 实例组成:一个静态前缀(您的基础指令)和一个动态后缀(advisor 注入的、每次请求都可能变化的上下文)。
默认情况下,当启用 SYSTEM_ONLY 或 SYSTEM_AND_TOOLS 缓存时,每个 SystemMessage 都会作为单独的 SystemContentBlock 发出,且缓存点位于最后一个块之后。如果该内容在请求之间发生任何变化,整个系统缓存都会被标记为失效——这将导致每次请求都产生 1.25 倍的缓存写入成本,而不是成本更低的缓存读取操作。
multiBlockSystemCaching 选项通过将缓存点放置在倒数第二个系统块之后(即静态前缀与动态后缀的边界处)来解决此问题,从而确保即使最后一个块自由变化,静态部分仍能保持缓存。
BedrockCacheOptions cacheOptions = BedrockCacheOptions.builder()
    .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
    .multiBlockSystemCaching(true)
    .ttl(BedrockCacheTtl.ONE_HOUR)
    .build();

BedrockChatOptions chatOptions = BedrockChatOptions.builder()
    .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
    .cacheOptions(cacheOptions)
    .build();

// Static system prompt (will be cached)
SystemMessage staticPrompt = new SystemMessage("You are an expert assistant...");
// Dynamic RAG context (injected by advisor, changes each request)
SystemMessage dynamicContext = new SystemMessage("Relevant context: " + ragResults);

Prompt prompt = new Prompt(List.of(staticPrompt, dynamicContext, new UserMessage("...")), chatOptions);
这会产生一个 Bedrock system 数组,其形式为 [text(static), cachePoint, text(dynamic)],因此只有静态前缀会参与缓存键的计算。
如果仅存在单个 SystemMessage,缓存点将放置在该单个块之后(与默认行为相同)。multiBlockSystemCaching 选项仅在存在两个或更多系统消息时改变缓存点的放置位置。
消息的顺序很重要。缓存点始终位于倒数第二个系统块之后,因此静态内容必须出现在动态内容之前。如果你将基础指令注册为第一个 SystemMessage,并让 advisors 在其后追加动态上下文,那么这一顺序要求将自然满足。
使用 ChatClient 流畅 API
String response = ChatClient.create(chatModel)
    .prompt()
    .system("You are an expert document analyst...")
    .user("Analyze this large document: " + document)
    .options(BedrockChatOptions.builder()
        .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
        .cacheOptions(BedrockCacheOptions.builder()
            .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
            .build())
        .build())
    .call()
    .content();
使用示例
下面是一个完整的示例,展示如何结合成本追踪使用提示词缓存:
// Create system content that will be reused multiple times
String largeSystemPrompt = "You are an expert software architect specializing in distributed systems...";
// (Ensure this is 1024+ tokens for cache effectiveness)

// First request - creates cache
ChatResponse firstResponse = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage(largeSystemPrompt),
            new UserMessage("What is microservices architecture?")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                .build())
            .maxTokens(500)
            .build()
    )
);

// Access cache-related token usage from metadata
Integer cacheWrite1 = (Integer) firstResponse.getMetadata()
    .getMetadata()
    .get("cacheWriteInputTokens");
Integer cacheRead1 = (Integer) firstResponse.getMetadata()
    .getMetadata()
    .get("cacheReadInputTokens");

System.out.println("Cache creation tokens: " + cacheWrite1);
System.out.println("Cache read tokens: " + cacheRead1);

// Second request with same system prompt - reads from cache
ChatResponse secondResponse = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage(largeSystemPrompt),  // Same prompt - cache hit
            new UserMessage("What are the benefits of event sourcing?")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                .build())
            .maxTokens(500)
            .build()
    )
);

Integer cacheWrite2 = (Integer) secondResponse.getMetadata()
    .getMetadata()
    .get("cacheWriteInputTokens");
Integer cacheRead2 = (Integer) secondResponse.getMetadata()
    .getMetadata()
    .get("cacheReadInputTokens");

System.out.println("Cache creation tokens: " + cacheWrite2); // Should be 0
System.out.println("Cache read tokens: " + cacheRead2);      // Should be > 0
令牌使用情况跟踪
AWS Bedrock 通过响应提供缓存特定指标。您可以通过两种方法访问缓存指标:
原生使用对象(推荐用于可观测性)
对于可观测性处理器和指标收集,通过原生的 TokenUsage 对象访问缓存指标:
import software.amazon.awssdk.services.bedrockruntime.model.TokenUsage;

ChatResponse response = chatModel.call(/* ... */);

// Access cache metrics from native TokenUsage object
TokenUsage tokenUsage = (TokenUsage) response.getMetadata()
    .getUsage()
    .getNativeUsage();

if (tokenUsage != null) {
    Integer cacheWrite = tokenUsage.cacheWriteInputTokens();
    Integer cacheRead = tokenUsage.cacheReadInputTokens();
    System.out.println("Cache write: " + cacheWrite + ", Cache read: " + cacheRead);
}
元数据映射(向后兼容)
缓存指标也可通过元数据 Map 获取,以保持向后兼容性:
ChatResponse response = chatModel.call(/* ... */);

// Access cache metrics from metadata Map
Integer cacheWrite = (Integer) response.getMetadata()
    .getMetadata()
    .get("cacheWriteInputTokens");
Integer cacheRead = (Integer) response.getMetadata()
    .getMetadata()
    .get("cacheReadInputTokens");
缓存特定指标包括:
-
cacheWriteInputTokens:返回创建缓存条目时使用的 token 数量 -
cacheReadInputTokens:返回从现有缓存条目中读取的 token 数量
首次发送缓存提示时: - cacheWriteInputTokens 的值将大于 0 - cacheReadInputTokens 的值将为 0
当您再次发送相同的缓存提示(在 5 分钟 TTL 内): - cacheWriteInputTokens 将为 0 - cacheReadInputTokens 将大于 0
实际应用场景
法律文档分析
通过在不同问题之间缓存文档内容,高效分析大型法律合同或合规文档:
// Load a legal contract (PDF or text)
String legalContract = loadDocument("merger-agreement.pdf"); // ~3000 tokens

// System prompt with legal expertise
String legalSystemPrompt = "You are an expert legal analyst specializing in corporate law. " +
    "Analyze the following contract and provide precise answers about terms, obligations, and risks: " +
    legalContract;

// First analysis - creates cache
ChatResponse riskAnalysis = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage(legalSystemPrompt),
            new UserMessage("What are the key termination clauses and associated penalties?")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                .build())
            .maxTokens(1000)
            .build()
    )
);

// Subsequent questions reuse cached document - 90% cost savings
ChatResponse obligationAnalysis = chatModel.call(
    new Prompt(
        List.of(
            new SystemMessage(legalSystemPrompt), // Same content - cache hit
            new UserMessage("List all financial obligations and payment schedules.")
        ),
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                .build())
            .maxTokens(1000)
            .build()
    )
);
批量代码审查
缓存审查准则,同时使用一致的审查标准处理多个代码文件:
// Define comprehensive code review guidelines
String reviewGuidelines = """
    You are a senior software engineer conducting code reviews. Apply these criteria:
    - Security vulnerabilities and best practices
    - Performance optimizations and memory usage
    - Code maintainability and readability
    - Testing coverage and edge cases
    - Design patterns and architecture compliance
    """;

List<String> codeFiles = Arrays.asList(
    "UserService.java", "PaymentController.java", "SecurityConfig.java"
);

List<String> reviews = new ArrayList<>();

for (String filename : codeFiles) {
    String sourceCode = loadSourceFile(filename);

    ChatResponse review = chatModel.call(
        new Prompt(
            List.of(
                new SystemMessage(reviewGuidelines), // Cached across all reviews
                new UserMessage("Review this " + filename + " code:\n\n" + sourceCode)
            ),
            BedrockChatOptions.builder()
                .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
                .cacheOptions(BedrockCacheOptions.builder()
                    .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                    .build())
                .maxTokens(800)
                .build()
        )
    );

    reviews.add(review.getResult().getOutput().getText());
}

// Guidelines cached after first request, subsequent reviews are faster and cheaper
结合知识库的客户服务
创建一个客户支持系统,用于缓存您的产品知识库,以提供一致且准确的响应:
// Load comprehensive product knowledge
String knowledgeBase = """
    PRODUCT DOCUMENTATION:
    - API endpoints and authentication methods
    - Common troubleshooting procedures
    - Billing and subscription details
    - Integration guides and examples
    - Known issues and workarounds
    """ + loadProductDocs(); // ~2500 tokens

@Service
public class CustomerSupportService {

    public String handleCustomerQuery(String customerQuery, String customerId) {
        ChatResponse response = chatModel.call(
            new Prompt(
                List.of(
                    new SystemMessage("You are a helpful customer support agent. " +
                        "Use this knowledge base to provide accurate solutions: " + knowledgeBase),
                    new UserMessage("Customer " + customerId + " asks: " + customerQuery)
                ),
                BedrockChatOptions.builder()
                    .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
                    .cacheOptions(BedrockCacheOptions.builder()
                        .strategy(BedrockCacheStrategy.SYSTEM_ONLY)
                        .build())
                    .maxTokens(600)
                    .build()
            )
        );

        return response.getResult().getOutput().getText();
    }
}

// Knowledge base is cached across all customer queries
// Multiple support agents can benefit from the same cached content
多租户 SaaS 应用
在跨不同租户共享工具定义缓存的同时,针对每个租户定制系统提示:
// Shared tool definitions (cached once, used across all tenants)
List<FunctionToolCallback> sharedTools = createLargeToolRegistry(); // ~2000 tokens

// Tenant-specific configuration
@Service
public class MultiTenantAIService {

    public String processRequest(String tenantId, String userQuery) {
        // Load tenant-specific system prompt (changes per tenant)
        String tenantPrompt = loadTenantSystemPrompt(tenantId);

        ChatResponse response = chatModel.call(
            new Prompt(
                List.of(
                    new SystemMessage(tenantPrompt), // Tenant-specific, not cached
                    new UserMessage(userQuery)
                ),
                BedrockChatOptions.builder()
                    .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
                    .cacheOptions(BedrockCacheOptions.builder()
                        .strategy(BedrockCacheStrategy.TOOLS_ONLY)
                        .build())
                    .toolCallbacks(sharedTools) // Shared tools - cached
                    .maxTokens(500)
                    .build()
            )
        );

        return response.getResult().getOutput().getText();
    }
}

// Tools cached once, each tenant gets customized system prompt
最佳实践
-
选择合适的策略:
- 对于可复用的系统提示词和指令,使用
SYSTEM_ONLY(适用于所有模型) - 当拥有大型且稳定的工具但系统提示词是动态变化时,使用
TOOLS_ONLY(仅限 Claude) - 当系统提示词和工具都是大型且稳定的时候,使用
SYSTEM_AND_TOOLS(仅限 Claude) - 对于多轮对话,结合 ChatClient 记忆功能使用
CONVERSATION_HISTORY - 使用
NONE显式禁用缓存
- 对于可复用的系统提示词和指令,使用
-
满足令牌要求:专注于缓存那些满足最低令牌要求(大多数模型为 1024 个令牌以上)的内容。
-
重用完全相同的内容:缓存机制在提示词内容完全匹配时效果最佳。即使发生微小变化,也需要创建新的缓存条目。
-
监控令牌使用情况:使用元数据指标跟踪缓存的有效性:
Integer cacheWrite = (Integer) response.getMetadata().getMetadata().get("cacheWriteInputTokens");
Integer cacheRead = (Integer) response.getMetadata().getMetadata().get("cacheReadInputTokens");
if (cacheRead != null && cacheRead > 0) {
    System.out.println("Cache hit: " + cacheRead + " tokens saved");
} -
战略性缓存点放置:该实现会根据您选择的策略,自动在最优位置放置缓存断点,以确保符合 AWS Bedrock 的 4 个断点限制。
-
缓存有效期:AWS Bedrock 的缓存默认具有 5 分钟的 TTL(Time To Live),但也支持 1 小时的 TTL 时长。每次缓存访问都会重置计时器。您可以通过
BedrockCacheOptions上的BedrockCacheTtl或通过spring.ai.bedrock.converse.chat.cache-options.ttl属性进行配置。 -
模型兼容性:注意特定模型的局限性:
- Claude 模型:支持所有缓存策略
- Amazon Nova 模型:仅支持
SYSTEM_ONLY和CONVERSATION_HISTORY(不支持工具缓存)
-
工具稳定性:当使用
TOOLS_ONLY、SYSTEM_AND_TOOLS或CONVERSATION_HISTORY策略时,请确保工具保持稳定。更改工具定义会导致级联失效,从而使所有下游缓存断点失效。
缓存失效与级联行为
AWS Bedrock 采用具有级联失效(cascade invalidation)机制的层级缓存模型:
缓存层级:Tools → System → Messages
每一层的变更都会使该层及其后续所有层失效:
| 变更内容 | 工具缓存 | 系统缓存 | 消息缓存 |
|---|---|---|---|
| 工具 | ❌ 无效 | ❌ 无效 | ❌ 无效 |
| 系统 | ✅ 有效 | ❌ 无效 | ❌ 无效 |
| 消息 | ✅ 有效 | ✅ 有效 | ❌ 无效 |
使用 SYSTEM_AND_TOOLS 策略的示例:
// Request 1: Cache both tools and system
ChatResponse r1 = chatModel.call(
    new Prompt(
        List.of(new SystemMessage("System prompt"), new UserMessage("Question")),
        BedrockChatOptions.builder()
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_AND_TOOLS)
                .build())
            .toolCallbacks(tools)
            .build()
    )
);
// Result: Both caches created

// Request 2: Change only system prompt (tools same)
ChatResponse r2 = chatModel.call(
    new Prompt(
        List.of(new SystemMessage("DIFFERENT system prompt"), new UserMessage("Question")),
        BedrockChatOptions.builder()
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_AND_TOOLS)
                .build())
            .toolCallbacks(tools) // SAME tools
            .build()
    )
);
// Result: Tools cache HIT (reused), system cache MISS (recreated)

// Request 3: Change tools (system same as Request 2)
ChatResponse r3 = chatModel.call(
    new Prompt(
        List.of(new SystemMessage("DIFFERENT system prompt"), new UserMessage("Question")),
        BedrockChatOptions.builder()
            .cacheOptions(BedrockCacheOptions.builder()
                .strategy(BedrockCacheStrategy.SYSTEM_AND_TOOLS)
                .build())
            .toolCallbacks(newTools) // DIFFERENT tools
            .build()
    )
);
// Result: BOTH caches MISS (tools change invalidates everything downstream)
实现细节
Spring AI 中的提示缓存实现遵循以下关键设计原则:
-
策略性缓存点放置:缓存断点会根据所选策略自动放置在最优位置,确保符合 AWS Bedrock 的 4 个断点限制。
-
提供商可移植性:缓存配置通过
BedrockChatOptions而非单个消息进行,从而在切换不同 AI 提供商时保持兼容性。 -
线程安全性:缓存断点跟踪采用线程安全机制实现,以正确处理并发请求。
-
UNION 类型模式:AWS SDK 使用 UNION 类型,其中缓存点作为独立的块添加,而非作为属性。这与直接 API 方法不同,但确保了类型安全和 API 合规性。
-
增量缓存:
CONVERSATION_HISTORY策略将缓存断点放置在最后一条用户消息上,实现增量缓存,使每一轮对话都基于之前缓存的前缀进行构建。
成本考虑
AWS Bedrock 提示词缓存的定价(近似值,因模型而异):
- 缓存写入:比基础输入令牌(base input tokens)贵 ~25%
- 缓存读取:便宜 ~90%(仅为基础输入令牌价格的 10%)
- 盈亏平衡点:只需 1 次缓存读取,即可节省成本
示例成本计算:
// System prompt: 2000 tokens
// User question: 50 tokens

// Without caching (5 requests):
// Cost: 5 × (2000 + 50) = 10,250 tokens at base rate

// With caching (5 requests):
// Request 1: 2000 tokens × 1.25 (cache write) + 50 = 2,550 tokens
// Requests 2-5: 4 × (2000 × 0.10 (cache read) + 50) = 4 × 250 = 1,000 tokens
// Total: 2,550 + 1,000 = 3,550 tokens equivalent

// Savings: (10,250 - 3,550) / 10,250 = 65% cost reduction
工具调用
BedrockProxyChatModel 支持工具调用。模型可以请求执行工具,但不会自行运行工具——Spring AI 负责处理执行。
在大多数应用中,请结合自动注册的 ToolCallingAdvisor 使用 ChatClient — 参见 工具调用。如需低级别控制并自行驱动循环(例如,将工具调用与提示词缓存结合使用时),参见 ChatModel 工具调用。
使用工具调用进行推理
当启用扩展思考且模型决定调用工具时,该响应中的签名推理块会被自动保留,并在后续请求中与工具结果一同重放。Amazon Bedrock 要求在重放时必须包含这些推理块——若省略它们,将导致 API 错误。
无需特殊配置。Spring AI 可以透明地处理重放操作,无论您使用的是自动管理的工具循环(即配置了 ToolCallingAdvisor 的 ChatClient),还是通过 ToolCallingManager 手动驱动循环。
结构化输出
AWS Bedrock 通过 JSON Schema 支持原生的结构化输出,确保模型生成的响应严格符合您指定的结构。该功能适用于 支持的模型,包括 Anthropic Claude 和 Amazon Nova。
使用 ChatClient 与原生结构化输出
使用结构化输出的最简单方式是借助 ChatClient 高级 API 和 ENABLE_NATIVE_STRUCTURED_OUTPUT 顾问(advisor):
record ActorsFilms(String actor, List<String> movies) {}

ActorsFilms actorsFilms = ChatClient.create(chatModel).prompt()
    .options(ToolCallingChatOptions.builder()
        .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
        .build())
    .advisors(AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT)
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class);
该方法会自动地:
- 从您的 Java 类生成 JSON schema
- 通过 AWS Bedrock
OutputConfigAPI 在BedrockChatOptions上设置outputSchema - 将 JSON 响应解析为您指定的类型
直接使用 outputSchema
如需更多控制,可以直接在 BedrockChatOptions 上设置 JSON schema:
String jsonSchema = """
        {
            "type": "object",
            "properties": {
                "actor": { "type": "string" },
                "movies": {
                    "type": "array",
                    "items": { "type": "string" }
                }
            },
            "required": ["actor", "movies"],
            "additionalProperties": false
        }
        """;

ChatResponse response = chatModel.call(
    new Prompt("Generate the filmography for a random actor.",
        BedrockChatOptions.builder()
            .model("us.anthropic.claude-haiku-4-5-20251001-v1:0")
            .outputSchema(jsonSchema)
            .build()));

String content = response.getResult().getOutput().getText();
AWS Bedrock 的结构化输出在构建 OutputConfig 时,内部使用固定的模式名称 response_schema。该 JSON 模式会直接传递给 AWS SDK 的 JsonSchemaDefinition。
有关更多信息,请参阅 结构化输出 文档。
多模态
多模态是指模型能够同时理解和处理来自多种信息源的能力,这些信息源包括文本、图像、视频、PDF、DOC、HTML、MD 以及更多数据格式。
Bedrock Converse API 支持多模态输入,包括文本和图像输入,并且可以基于组合输入生成文本响应。
您需要一个支持多模态输入的模型,例如 Anthropic Claude 或 Amazon Nova 模型。
图像
对于支持视觉多模态的模型(例如 Amazon Nova、Anthropic Claude、Llama 3.2),Bedrock Converse API 允许在请求负载中包含多张图片。这些模型可以分析传入的图片并回答问题、对图片进行分类,以及根据提供的指令对图片进行摘要。
目前,Bedrock Converse 支持 base64 编码的 image/jpeg、image/png、image/gif 和 image/webp MIME 类型图像。
Spring AI 的 Message 接口通过引入 Media 类型支持多模态 AI 模型。它包含消息中媒体附件的数据和信息,并使用 Spring 的 org.springframework.util.MimeType 以及一个用于原始媒体数据的 java.lang.Object。
以下是一个简单的代码示例,演示了将用户文本与图片进行组合。
String response = ChatClient.create(chatModel)
    .prompt()
    .user(u -> u.text("Explain what do you see on this picture?")
        .media(Media.Format.IMAGE_PNG, new ClassPathResource("/test.png")))
    .call()
    .content();

logger.info(response);
其输入为 test.png 图像:

同时附带文本消息“Explain what do you see on this picture?”,并生成如下形式的响应:
The image shows a close-up view of a wire fruit basket containing several pieces of fruit.
...
视频
Amazon Nova 模型 允许在 payload 中包含单个视频,该视频可以以 base64 格式提供,也可以通过 Amazon S3 URI 提供。
目前,Bedrock Nova 支持 video/x-matroska、video/quicktime、video/mp4、video/webm、video/x-flv、video/mpeg、video/x-ms-wmv 和 video/3gpp 等 mime 类型的视频。
Spring AI 的 Message 接口通过引入 Media 类型来支持多模态 AI 模型。它包含消息中媒体附件的数据及信息,使用 Spring 的 org.springframework.util.MimeType 和用于原始媒体数据的 java.lang.Object。
以下是一个简单的代码示例,展示了如何将用户文本与视频结合。
String response = ChatClient.create(chatModel)
    .prompt()
    .user(u -> u.text("Explain what do you see in this video?")
        .media(Media.Format.VIDEO_MP4, new ClassPathResource("/test.video.mp4")))
    .call()
    .content();

logger.info(response);
其输入为 test.video.mp4 图像:

并附带文本消息“解释一下你在视频中看到了什么?”,并生成类似如下的响应:
The video shows a group of baby chickens, also known as chicks, huddled together on a surface
...
文档
对于某些模型,Bedrock 允许通过 Converse API 的文档支持功能在负载中包含文档,这些文档可以以字节形式提供。文档支持有两种不同的变体,如下所述:
-
文本文档类型(txt、csv、html、md 等),重点在于文本理解。这类用例包括基于文档中的文本元素进行问答。
-
媒体文档类型(pdf、docx、xlsx),重点在于基于视觉的理解来回答问题。这类用例包括基于图表、图形等内容进行问答。
目前,Anthropic 的 PDF 支持(Beta) 和 Amazon Bedrock Nova 模型支持文档多模态。
下面是一个简单的代码示例,展示了用户文本与媒体文档的组合。
String response = ChatClient.create(chatModel)
    .prompt()
    .user(u -> u.text(
            "You are a very professional document summarization specialist. Please summarize the given document.")
        .media(Media.Format.DOC_PDF, new ClassPathResource("/spring-ai-reference-overview.pdf")))
    .call()
    .content();

logger.info(response);
它接受 spring-ai-reference-overview.pdf 文档作为输入:
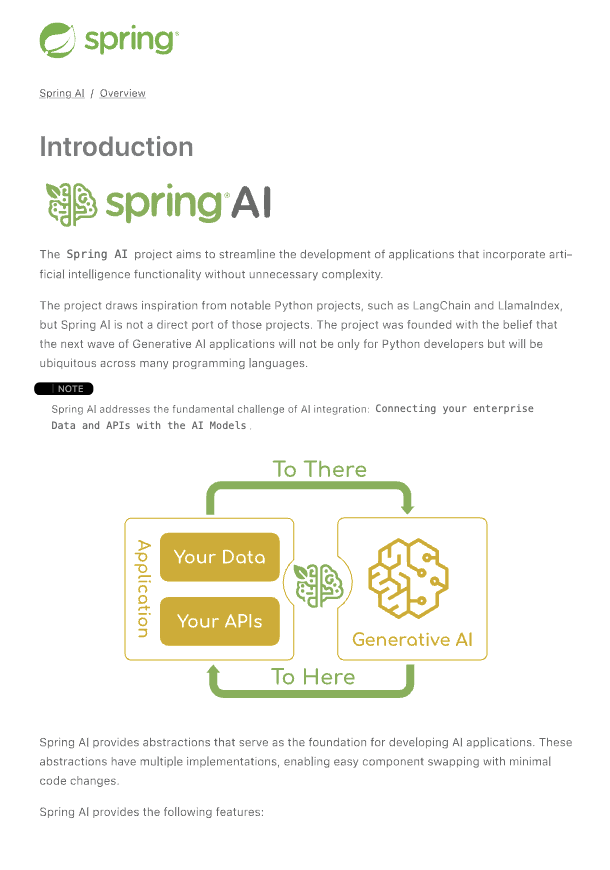
并附带文本消息“你是一个非常专业的文档摘要专家。请对给定的文档进行摘要。”,并生成类似如下的响应:
**Introduction:**
- Spring AI is designed to simplify the development of applications with artificial intelligence (AI) capabilities, aiming to avoid unnecessary complexity.
...
示例控制器
创建一个新的 Spring Boot 项目,并在依赖项中添加 spring-ai-starter-model-bedrock-converse。
在 src/main/resources 下添加一个 application.properties 文件:
spring.ai.bedrock.aws.region=eu-central-1
spring.ai.bedrock.aws.timeout=10m
spring.ai.bedrock.aws.access-key=${AWS_ACCESS_KEY_ID}
spring.ai.bedrock.aws.secret-key=${AWS_SECRET_ACCESS_KEY}
# session token is only required for temporary credentials
spring.ai.bedrock.aws.session-token=${AWS_SESSION_TOKEN}

spring.ai.bedrock.converse.chat.temperature=0.8
spring.ai.bedrock.converse.chat.top-k=15
下面是一个使用聊天模型的控制器示例:
@RestController
public class ChatController {

    private final ChatClient chatClient;

    @Autowired
    public ChatController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @GetMapping("/ai/generate")
    public Map generate(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
        return Map.of("generation", this.chatClient.prompt(message).call().content());
    }

    @GetMapping("/ai/generateStream")
    public Flux<ChatResponse> generateStream(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
        return this.chatClient.prompt(message).stream().content();
    }
}