Recursive Advisors
什么是 Recursive Advisor?
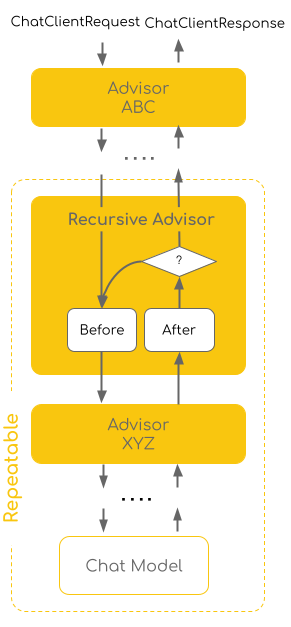
递归 advisor 是一种特殊类型的 advisor,可以多次循环遍历下游 advisor 链。当需要反复调用 LLM 直到满足某个条件时,这种模式非常有用,例如:
-
循环执行工具调用,直到不再需要调用工具
-
验证结构化输出,并在验证失败时重试
-
实现评估逻辑,并对请求进行修改
-
实现重试逻辑,并对请求进行修改
CallAdvisorChain.copy(CallAdvisor after) 方法是支持递归 advisor 模式的关键工具。它会创建一个新的 advisor 链,其中仅包含原始链中位于指定 advisor 之后的 advisor,并允许递归 advisor 按需调用这个子链。这种方式确保了:
-
递归 advisor 可以循环遍历链中剩余的 advisors
-
链中的其他 advisors 可以观察并拦截每次迭代
-
advisor 链保持适当的顺序和可观察性
-
递归 advisor 不会重新执行在它之前的 advisors
内置递归 Advisors
Spring AI 提供了两个内置的 recursive advisors 来演示这种模式。
ToolCallingAdvisor
ToolCallingAdvisor 将工具调用循环实现为 advisor 链的一部分,而不是依赖每个 ChatModel 的内部执行。只要存在工具,它就会由 DefaultChatClient 自动注册,并且是 ChatClient 驱动工具增强对话的默认机制。
亮点:
-
循环遍历 advisor chain,直到
ToolExecutionEligibilityChecker报告没有更多 tool calls。 -
使用
callAdvisorChain.copy(this)创建一个用于递归调用的 sub-chain — 其他 advisor 可以观察并拦截每一次迭代。 -
支持 return-direct:当某个 tool 的结果包含
returnDirect = true时,该 advisor 会中断循环,并将 tool 结果返回给调用方,而不会将其发送回 LLM。 -
实现
ToolAdvisormarker interface,DefaultChatClient使用该接口来强制实施 single-tool-advisor 不变式 — 自定义子类可以透明地注册为替代实现。 -
在循环的每一次迭代中累积 token 用量,因此最终的
ChatResponse会报告所有模型调用的累计用量,而不仅仅是最后一次调用的用量(参见 多步骤流程中的累计用量)。
简短示例:
var toolCallingAdvisor = ToolCallingAdvisor.builder()
    .toolCallingManager(toolCallingManager)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300)
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(toolCallingAdvisor)
    .build();
有关完整的 builder API、hook 方法、配置选项、memory-advisor 排序交互、用户控制的执行模式以及 custom-subclass 扩展模式,请参阅 ToolCallingAdvisor。
有关 tool loop 如何融入更广泛的 tool calling 架构的概念概述,请参见 Tool Calling: The Tool Calling Loop。
如需了解使用 `ToolCallingAdvisor’s extension hooks 实现渐进式工具披露的具体子类,请参见 Tool Search Tool。
StructuredOutputValidationAdvisor
StructuredOutputValidationAdvisor 会根据 JSON schema 验证结构化 JSON 输出,并在验证失败时重试调用,最多可配置尝试次数。
主要特性:
-
从预期输出类型派生 JSON schema,或接受预先提供的 schema 字符串。
-
根据 schema 校验 LLM 响应。
-
在校验失败时重试调用(默认:最多 3 次尝试)。
-
在重试尝试中向 prompt 追加校验错误信息,以帮助模型自我纠正。
-
使用
callAdvisorChain.copy(this)创建用于递归调用的子链。 -
累积每次校验尝试的 token 用量,因此返回的
ChatResponse会报告所有重试的累积用量,而不仅是最后一次尝试(参见 多步流程中的累积用量)。 -
可选支持自定义
JsonMapper。
advisor 可以通过 outputType(自动派生 schema)或 outputJsonSchema(预先提供的 schema 字符串)进行配置;这两个选项互斥。
带 outputType 的示例:
var validationAdvisor = StructuredOutputValidationAdvisor.builder()
    .outputType(MyResponseType.class)
    .maxRepeatAttempts(3)
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(validationAdvisor)
    .build();
使用预先提供的 JSON schema 的示例:
var validationAdvisor = StructuredOutputValidationAdvisor.builder()
    .outputJsonSchema(myConverter.getJsonSchema())
    .build();
或者,通过 EntityParamSpec consumer 直接在 entity() 调用上启用 schema validation,而无需手动配置 advisor:
ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorFilms.class, spec -> spec.validateSchema());
请参阅 Schema Validation & Self-Correction 了解高层用法。
在自定义递归 Advisor 中累积 Token 用量
递归 advisor 在每次调用时会执行多次模型调用,因此它必须累计每次调用的 token 用量,以报告正确的累计总量;否则调用方只能看到最后一次调用的用量。Spring AI 提供了 org.springframework.ai.chat.client.advisor.UsageAccumulator 来简化这一过程。为每次 adviseCall 调用创建一个实例(或者为每个流式订阅创建一个实例,放在 Flux.defer 内部,以保持其作用域限于该订阅),使用 addRoundResponse(… ) 将每一轮响应合并进来,并使用 applyAccumulatedUsage(… ) 将累计总量写入最终响应:
UsageAccumulator usage = new UsageAccumulator();
ChatClientResponse response;
do {
    response = callAdvisorChain.copy(this).nextCall(request);
    usage.addRoundResponse(response.chatResponse());
    // ... decide whether to loop again ...
}
while (loopAgain);
return usage.applyAccumulatedUsage(response);
底层的 token 计算位于 org.springframework.ai.support.UsageCalculator(accumulateResponseUsage 和 withUsage)中,UsageAccumulator 对其进行了封装。